// ARCHIVE
计算机组成原理期末总复习
纪禄平《计算机组成原理》(第 6 版)期末冲刺笔记:按"总体框架 → 处理对象 → 硬件子系统"组织,覆盖数据表示与运算、CPU、存储、总线与 I/O、外设五大板块,配大量结构图、对比速查表、手算例题与各章典型题。
计算机组成原理期末总复习
适用教材:纪禄平、罗克露、刘辉、张建《计算机组成原理》(第 6 版),电子工业出版社,2024 年 7 月,"十二五"普通高等教育本科国家级规划教材。全书共 6 章:计算机系统概述、数据的表示·运算与校验、CPU 子系统、存储子系统、总线与 I/O 子系统、I/O 设备及其接口。
教材的组织线索是"总体框架 → 处理对象 → 硬件子系统":先建立整机概念(第 1 章),再讲数据的表示与运算(第 2 章),最后分述四大功能子系统(第 3~6 章)。
使用建议:本资料按"可以覆盖全书约八成考点"的密度编写。第 2、3、4 章是计算与设计题的重灾区,务必把例题动手演算一遍;第 1、5 章的公式套用性强,性价比高;第 6 章以记忆为主。文中标注"典型题"的部分建议全部手推。
资料整理自:
唐朔飞《计算机组成原理》、白中英《计算机组成原理》、Patterson & Hennessy《计算机组成与设计》等经典教材作交叉校验。
配图说明:正文中的原理图、芯片结构图等多数取自 Wikimedia Commons 等开放版权来源(CC / 公有领域),全部已本地化托管,逐图出处与许可证见 附录 A;少数通用结构图(数据通路、微程序控制器、总线与 I/O 传送对比等)为本站自绘。若内容与原书有出入,一律以 纪禄平《计算机组成原理》第 6 版 为准。
0. 复习总览
0.1 分值与题型的经验分布
各高校试卷结构不同,但常见构成为:选择/填空(约 30%)+ 简答/辨析(约 30%)+ 计算/设计(约 40%)。分值分布大致为:
| 板块 | 章节 | 典型分值占比 | 主要形式 |
|---|---|---|---|
| 数据表示与运算 | 第 2 章 | 25%~30% | 机器码互求、浮点编码、乘除法手算、校验码 |
| CPU 子系统 | 第 3 章 | 25%~35% | 寻址计算、扩展操作码、数据通路、流水线计算 |
| 存储子系统 | 第 4 章 | 20%~25% | 容量扩展、Cache 地址划分与命中率、磁盘与虚存 |
| 总线与 I/O | 第 5 章 | 10%~15% | 总线带宽、中断与 DMA 流程 |
| 系统概述与设备 | 第 1、6 章 | 5%~10% | 性能公式、层次结构、外设概念 |
0.2 高频计算与设计题型地图
| 题型 | 所在章 | 核心公式/方法 | 易错点 |
|---|---|---|---|
| 进制转换与机器码 | 第 2 章 | 原码/反码/补码/移码互求 | n 位补码范围到 −2^(n−1);移码 = 补码符号位取反 |
| 补码加减与溢出 | 第 2 章 | [X−Y]补 = [X]补 + [−Y]补 | 双符号位 01 正溢、10 负溢;"取反加一"别漏加 1 |
| 原码一位乘 / Booth | 第 2 章 | 部分积移位累加;Booth 按相邻两位判加减 | 符号位单独处理;移位的位数与补齐 |
| 原码除法 | 第 2 章 | 恢复余数法 / 加减交替法 | 上商顺序、余数左移 |
| 浮点数与 IEEE 754 | 第 2 章 | 真值 = (−1)^S × 1.M × 2^(E−127) | 阶码用移码(单精度偏置 127);尾数隐含最高位 1 |
| 浮点加减 | 第 2 章 | 对阶→尾数运算→规格化→舍入→判溢出 | 对阶是"小阶向大阶看齐",小阶尾数右移 |
| 海明码 / CRC | 第 2 章 | 2^r ≥ k + r + 1;CRC 模 2 除求余 | 海明校验位在 2^i 位置;CRC 余数要补足位数 |
| BCD 与字符编码 | 第 2 章 | 8421 码;机内码 = 国标码 + 8080H | 区位码与国标码差 2020H |
| 扩展操作码 | 第 3 章 | 高位留作长操作码的前缀 | 操作码不能互为前缀 |
| 有效地址计算 | 第 3 章 | 相对/基址/变址:EA = 基址 + A | 相对寻址相对的是取指后的 PC |
| CPU 性能公式 | 第 1、3 章 | CPU 时间 = 指令数 × CPI / 主频 | MIPS 与主频单位换算 |
| 数据通路微操作 | 第 3 章 | 单总线逐拍列出 R1→Y, ALU→Z 等 | 一拍内只能有一个部件向总线输出 |
| 流水线性能 | 第 3 章 | 加速比 = n·k / (k + n − 1) | k 是级数、n 是指令数,别混用 |
| 存储器容量扩展 | 第 4 章 | 位扩展拼数据线,字扩展译码选片 | 高位地址分配与片选逻辑 |
| Cache 映射与地址划分 | 第 4 章 | 标记/行号(组号)/块内地址切分 | 直接映射还需比较标记 |
| Cache 命中率与平均访问时间 | 第 4 章 | Ta = h·Tc + (1−h)·Tm | 写策略不同公式不同 |
| 虚拟存储器与 TLB | 第 4 章 | 页号/页内地址切分、页表项数换算 | 页表大小 = 页表项数 × 每项字节数 |
| 磁盘容量与存取时间 | 第 4 章 | 容量 = 盘面 × 磁道 × 扇区 × 扇区大小 | 平均旋转等待 = 半圈 = 1/(2r) |
| 总线带宽 | 第 5 章 | 带宽 = 总线宽度(字节) × 总线频率 | 位/字节换算 |
| 中断与 DMA | 第 5 章 | 中断处理四步;DMA 传送时间估算 | DMA 只在首尾占用 CPU |
0.3 各章一句话主线
| 章 | 一句话主线 | 必须能回答的问题 |
|---|---|---|
| 第 1 章 | 建立整机概念 | 计算机怎么"自动"工作?怎样衡量快慢? |
| 第 2 章 | 数据如何表示与运算 | 0/1 如何表示数、字符?运算器凭什么只会加法? |
| 第 3 章 | 指挥硬件干活 | 一条指令怎么被取出、译码、执行? |
| 第 4 章 | 把数据放好 | 大容量与高速度如何兼得? |
| 第 5 章 | 把部件连起来 | 谁用总线?数据怎么高效搬运? |
| 第 6 章 | 把信息送进送出 | 键盘、显示器、打印机如何与主机交互? |
0.4 相对弱化 / 背景性内容
以下内容在教材中仍有篇幅,但偏工程细节或已属历史,期末通常不深考,复习时可降低优先级:
| 内容 | 位置 | 说明 |
|---|---|---|
| 磁芯、磁泡存储器 | 第 4 章 | 已被半导体存储器取代,知道"曾存在"即可 |
| ROM 各工艺细节(MROM/PROM/EPROM) | 第 4 章 | 掌握"只读、可擦写性"差异即可 |
| 光盘(CD/DVD)读写物理机理 | 第 4 章 | 记住容量量级与光存储定位 |
| 键盘扫描码、去抖电路的精确时序 | 第 6 章 | 掌握矩阵扫描思想即可 |
| 打印机机械传动结构 | 第 6 章 | 记住击打式/非击打式、速度单位 |
| CRT 行场扫描电路细节 | 第 6 章 | 现代多为 LCD,掌握刷新与光栅扫描概念 |
| 各类总线标准的引脚时序(ISA/PCI/USB) | 第 5 章 | 知道总线分类与性能指标即可 |
1. 第 1 章 计算机系统概述
1.1 计算机的概念、类型与冯·诺依曼体制
计算机是一种能自动、高速地进行大量数值计算与各类信息处理的电子设备。按规模与用途可分为巨型机、大型机、小型机、微型机、单片机与嵌入式系统等;无论规模大小,它们都属于同一种体系结构——冯·诺依曼结构。
冯·诺依曼型计算机的基本思想(必背四条):
- 采用二进制表示数据和指令,指令由操作码和地址码组成;
- 存储程序:程序(指令序列)与数据一起存放在存储器中,机器按地址自动取用;
- 程序控制:指令按顺序执行,遇到转移指令才改变顺序;
- 五大部件:由运算器、控制器、存储器、输入设备、输出设备构成。
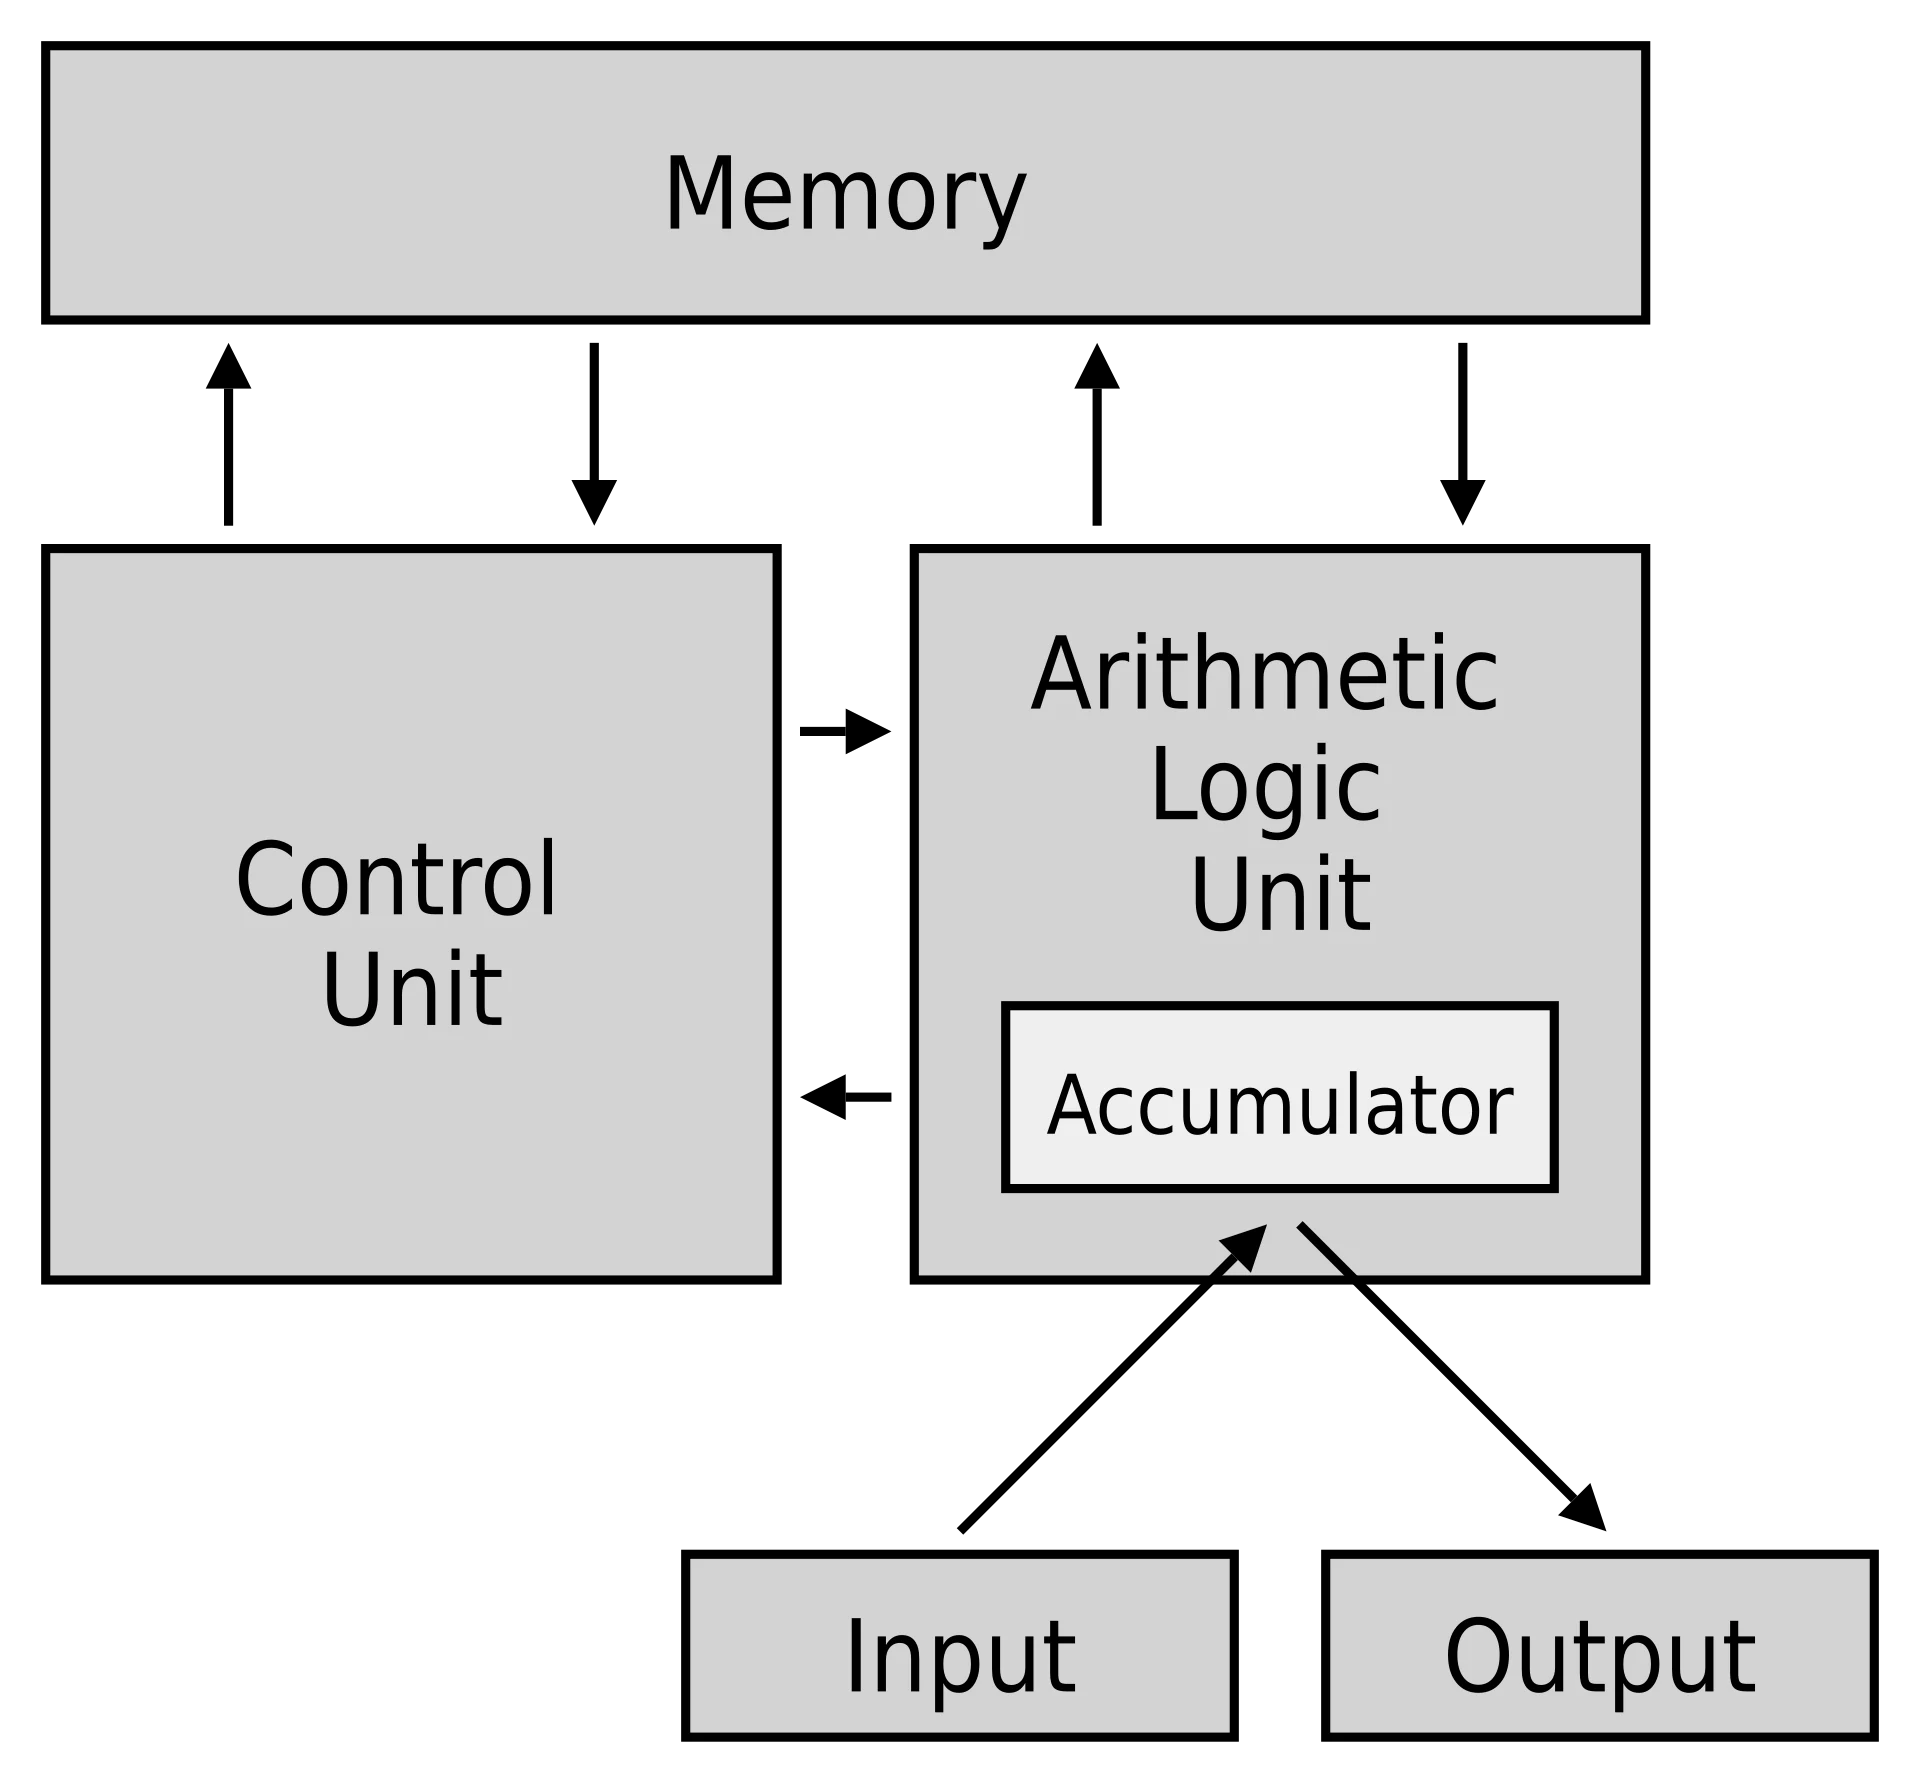
五大部件的分工:
| 部件 | 作用 | 现代实现 |
|---|---|---|
| 运算器 | 完成算术与逻辑运算 | 与控制器一起集成在 CPU 中 |
| 控制器 | 取指、译码、发出控制信号,协调各部件 | 同上 |
| 存储器 | 存放程序与数据 | 主存 + Cache + 磁盘(分层) |
| 输入设备 | 把外部信息送入计算机 | 键盘、鼠标、扫描仪 |
| 输出设备 | 把处理结果送出计算机 | 显示器、打印机 |
存储程序 + 程序控制是"自动计算"的关键:一旦程序装入存储器,机器便按 PC 指出的地址顺序取指、执行,人不再逐条干预。
与冯·诺依曼结构相对的是哈佛结构:指令存储器与数据存储器分开,因而取指与取数可以同时进行,效率更高。早期多用于 DSP 与单片机;现代 CPU 内部实际上也采用"分离的 L1 指令 Cache 与数据 Cache",属于哈佛结构的局部应用。
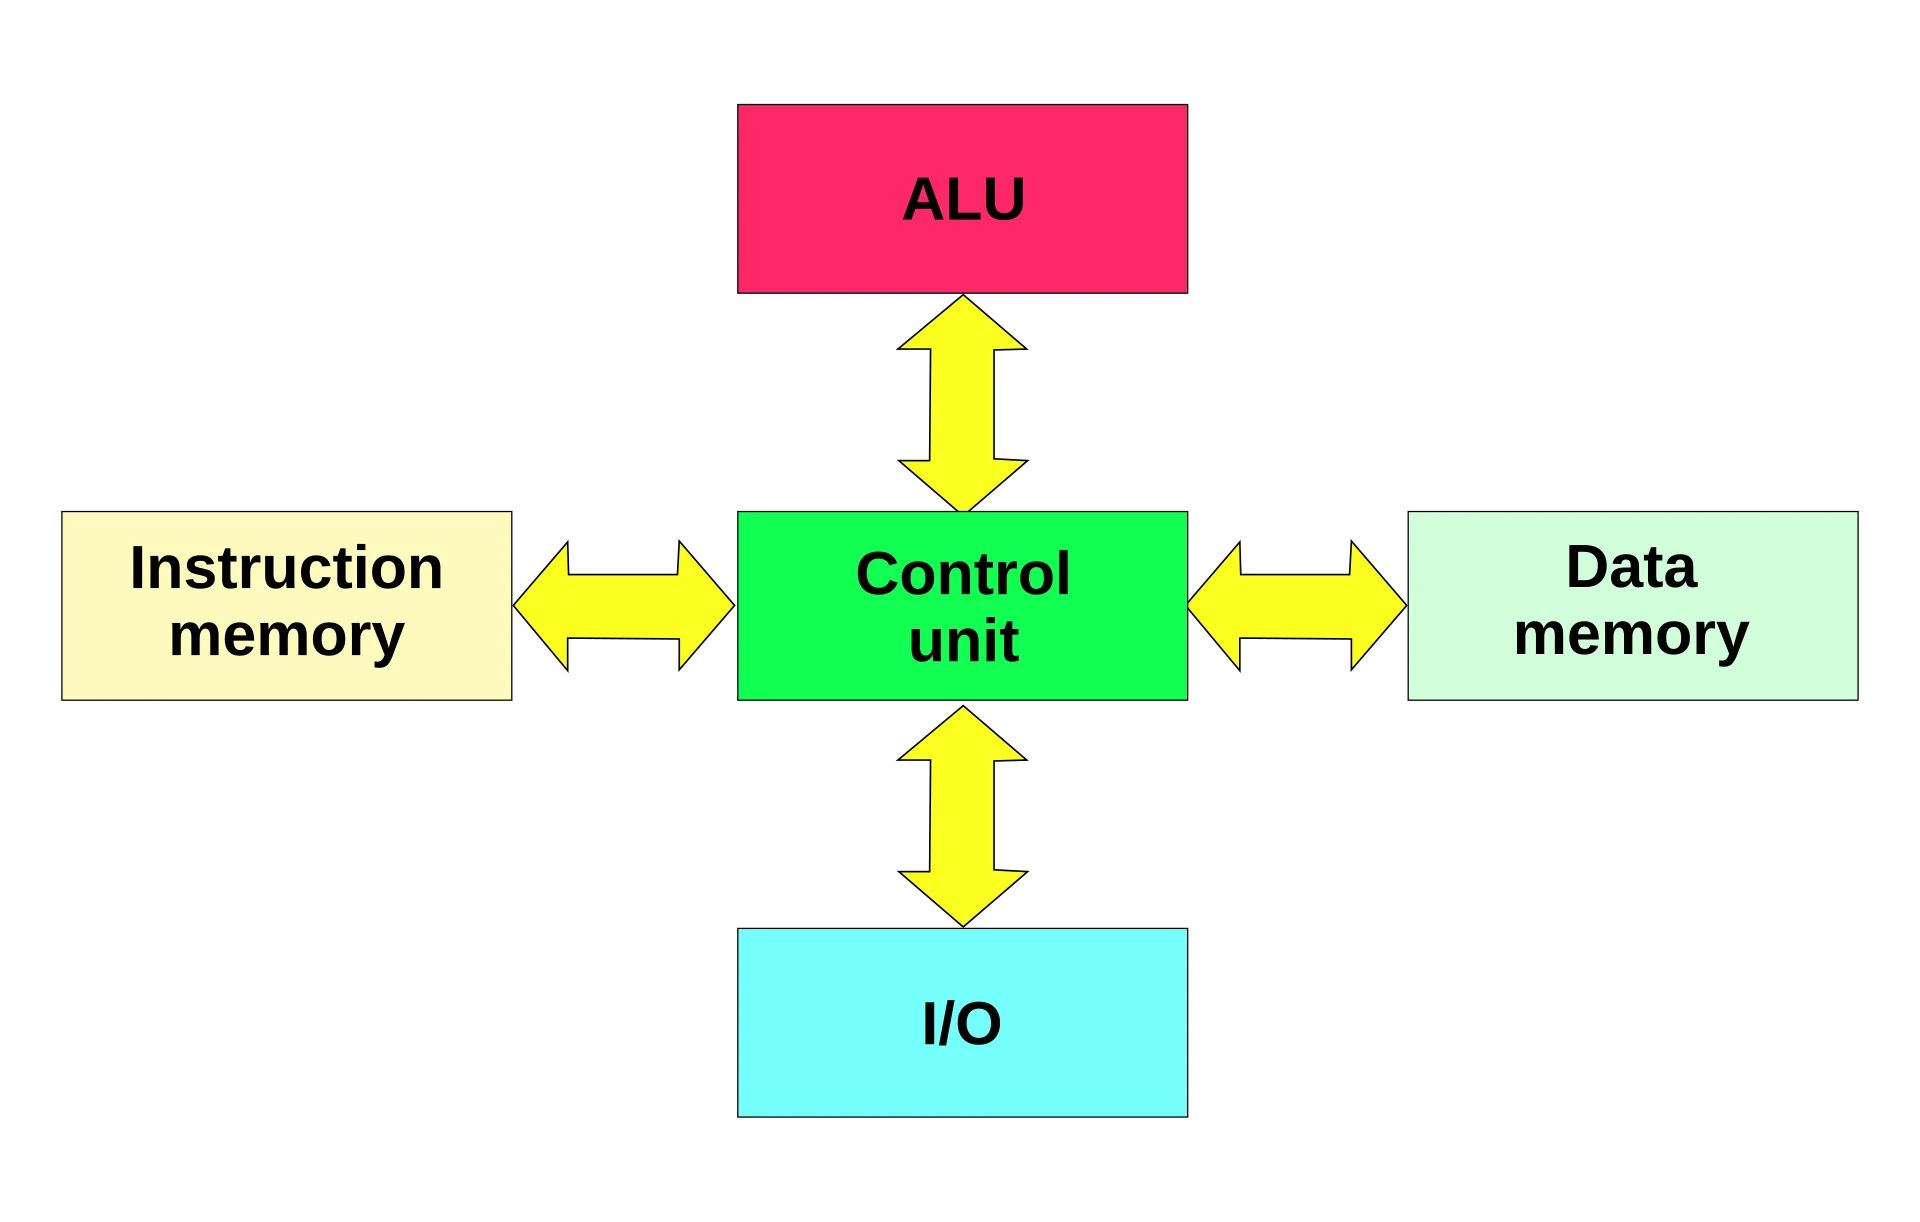
1.2 计算机的诞生与发展
| 分代 | 年代 | 主要元件 | 标志 |
|---|---|---|---|
| 第一代 | 1946—1957 | 电子管 | ENIAC、EDVAC(存储程序思想) |
| 第二代 | 1958—1964 | 晶体管 | 体积、功耗下降,可靠性提高 |
| 第三代 | 1965—1970 | 集成电路 | 中小规模 IC,出现操作系统雏形 |
| 第四代 | 1971 至今 | 大规模/超大规模 IC | 微处理器、PC、服务器 |
两条常考的"规律":
- 摩尔定律:集成电路上可容纳的晶体管数约每 18~24 个月翻一番,性能随之提升、成本下降。它是经验规律而非物理定律,近年已明显放缓。
- 冯·诺依曼瓶颈:CPU 与主存之间的带宽逐渐跟不上 CPU 的处理速度,成为性能瓶颈。这正是引入 **Cache(第 4 章)与流水线(第 3 章)**的直接动因。
发展趋势:多核与并行计算、嵌入式与物联网、云计算与异构加速、智能化。
1.3 计算机系统的层次结构与工作过程
计算机系统由硬件(实体)与软件(程序、数据、文档)组成,两者在逻辑功能上等价——同一个功能既可用硬件实现,也可用软件实现(如"乘法"可用乘法器完成,也可用加法与移位循环完成),取硬件实现通常更快、软件实现更省成本。
从上到下,每一层都把下一层"翻译"成更基本的形式,向上屏蔽细节:
| 层次 | 名称 | 由谁翻译 |
|---|---|---|
| M5 | 应用语言机器 | 应用程序 / 用户界面 |
| M4 | 高级语言机器 | 编译程序 |
| M3 | 汇编语言机器 | 汇编程序 |
| M2 | 操作系统机器 | 系统调用、资源管理 |
| M1 | 机器语言机器(实际机器) | 指令由硬件直接执行 |
| M0 | 微程序机器 | 微指令解释执行机器指令 |
计算机的工作过程可用一个例子串起来:计算 y = a × b + c。程序被装入存储器后:
- 取指:
PC → MAR,读主存得指令,送入IR,PC自动加 1; - 分析:控制器译码
IR中的操作码,判定这是"取数"还是"乘"等; - 执行:按地址码取
a、b到运算器,做乘法,再取c相加,结果写回; - 重复上述过程直到遇到停机指令。
1.4 计算机的主要性能指标
① 字长与容量
- 机器字长:CPU 一次能并行处理的二进制位数,通常等于通用寄存器宽度(如 32 位、64 位)。
- 指令字长:一条指令的位数,可为定长或变长。
- 存储字长:一个存储单元存放的二进制位数。
- 存储容量:以字节(B)为单位,
1 KB = 2^10 B,依次为 MB、GB、TB。
② 速度指标
-
主频 f 与时钟周期 T:
T = 1/f,是机器最小的节拍单位。 -
CPI(Cycles Per Instruction):执行一条指令平均所需时钟周期数。
-
CPU 执行时间(衡量性能最可靠的指标):
CPU 时间 = 指令条数 × CPI × 时钟周期 = 指令条数 × CPI / 主频 -
MIPS(每秒百万条指令):
MIPS = 指令条数 / (执行时间 × 10^6) = 主频 / (CPI × 10^6) -
MFLOPS / GFLOPS / TFLOPS:每秒百万/十亿/万亿次浮点运算,衡量科学计算能力。
-
吞吐量与响应时间:吞吐量是单位时间完成的任务数,响应时间是单个任务的完成时间。
③ Amdahl 定律(局部优化对整体的影响):
整体加速比 = 1 / [(1 − p) + p / s]
其中 p 是被优化部分所占比例,s 是该部分的加速倍数。它说明:只优化一部分,整体收益有上界(1/(1−p))。
例:某程序中 40% 的运算可以提速 10 倍,则整体加速比 =
1 / (0.6 + 0.4/10)≈ 1.56。
1.5 典型题
题 1:某 CPU 主频 2 GHz,程序共执行 2 × 10^8 条指令,平均 CPI = 1.5。求执行时间与 MIPS。
解:CPU 时间 = 2×10^8 × 1.5 / (2×10^9) = 0.15 s;MIPS = 2×10^9 / (1.5×10^6) ≈ 1333。
题 2:若主频提高 20% 而 CPI 上升 10%,程序执行时间是变快还是变慢?
解:时间 ∝ CPI / f,比值 = 1.10 / 1.20 ≈ 0.917,变快约 8.3%。这说明"主频高不一定更快",必须同时看 CPI 与指令条数。
题 3:什么是冯·诺依曼瓶颈?举出两种缓解手段。
解:CPU 与主存之间数据通路的速度增长慢于 CPU 处理速度,形成带宽瓶颈。缓解手段:① 设置 Cache,利用局部性把常用数据放在高速小容量存储器中;② 采用流水线/多级存储体系,提高访存与执行的并行度。
更多练习:见附录 C 自测清单。
2. 第 2 章 数据的表示、运算与校验
本章回答"计算机的处理对象是什么、怎么算"。主线是:怎样用 0/1 表示数 → 怎样表示字符 → 怎样运算 → 怎样发现出错。
2.1 数值型数据的表示
2.1.1 进位计数制及其转换
任意 r 进制数按"位权展开":(N)r = Σ aᵢ × r^i。常用基数:二进制 r=2、八进制 r=8、十六进制 r=16。
转换要点:
- r 进制 → 十进制:按位权展开求和;
- 十进制 → r 进制:整数部分"除 r 取余、逆序排列",小数部分"乘 r 取整、顺序排列";
- 二 ↔ 八/十六:按 3 位 / 4 位分组,直接替换(最方便,考试常走这条路)。
2.1.2 机器数:原码、反码、补码、移码
真值是带符号的实际数值,机器数是它在机器中的 0/1 表示。四个概念必须能互求:
| 编码 | 正数 | 负数 | 0 的表示 | 特点 |
|---|---|---|---|---|
| 原码 | 符号位 0 + 绝对值 | 符号位 1 + 绝对值 | 有两种(+0、−0) | 直观,用于乘除法的符号处理 |
| 反码 | 同原码 | 符号位不变,其余取反 | 有两种 | 求补码的中间步骤 |
| 补码 | 同原码 | 反码 + 1(取反加一) | 唯一 | 加减统一,机器实际使用 |
| 移码 | 补码符号位取反 | 补码符号位取反 | 唯一(1000…0) | 用于浮点数阶码,便于比较大小 |
补码的数学定义(n 位):当 X ≥ 0 时 [X]补 = X;当 X < 0 时 [X]补 = 2^n + X(模 2^n 意义下)。n 位补码的表示范围是 −2^(n−1) 到 2^(n−1) − 1,比原码多表示一个最小负数。例如 8 位补码:−128 到 +127。
为什么计算机用补码?因为"模运算"可以把减法变成加法:
钟表上"往后退 7 小时"等于"往前走 5 小时"(模 12)。同理,8 位机器里
−7等价于+249(模 256),于是X − Y只需写成X + (−Y)补,运算器只需要一个加法器。
2.1.3 定点表示
小数点位置固定:定点小数(小数点在符号位之后,表示 |x| 小于 1 的数)与定点整数(小数点在最低位之后)。优点是简单、运算快;缺点是表示范围小、精度固定。
2.1.4 浮点表示与 IEEE 754
浮点数把"数"拆成阶码 + 尾数,形如 N = S × r^E(S 为尾数、r 为基数、E 为阶码),用有限位表示大范围的数,代价是精度不再是均匀的。
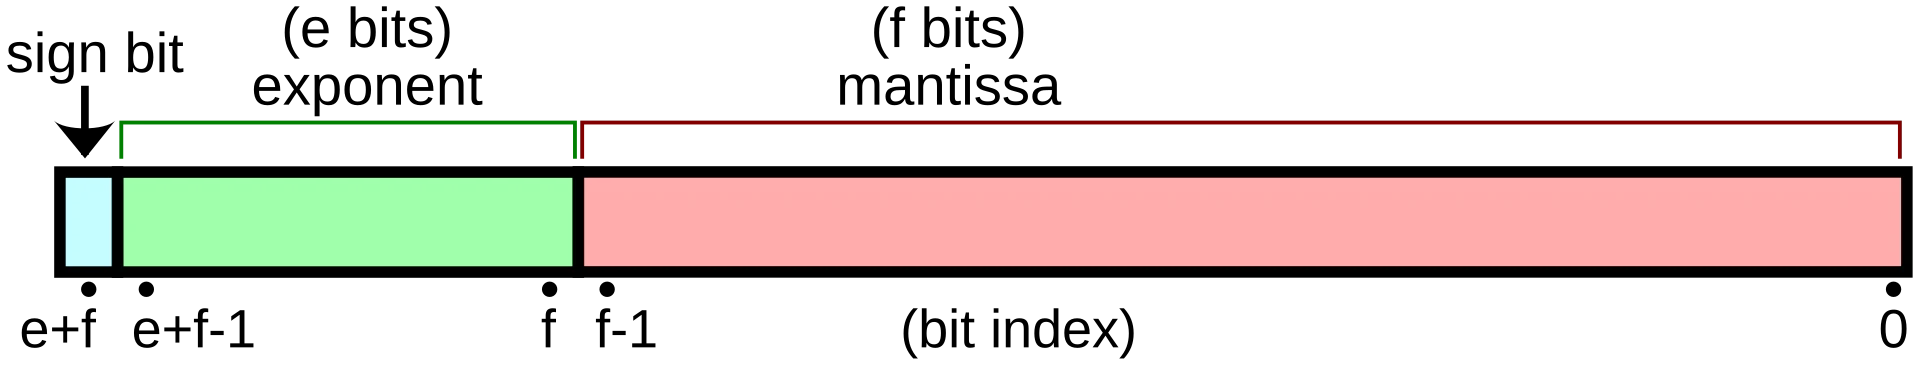
约定:
- 阶码用移码(含阶符),便于对阶时按无符号数比较大小;
- 尾数需规格化:原码规格化要求尾数最高数值位为 1(即
0.5 ≤ |M| < 1),补码规格化要求"符号位与最高数值位相反"; - 基数 r 常取 2,隐含不存。
IEEE 754 标准是考试重点:
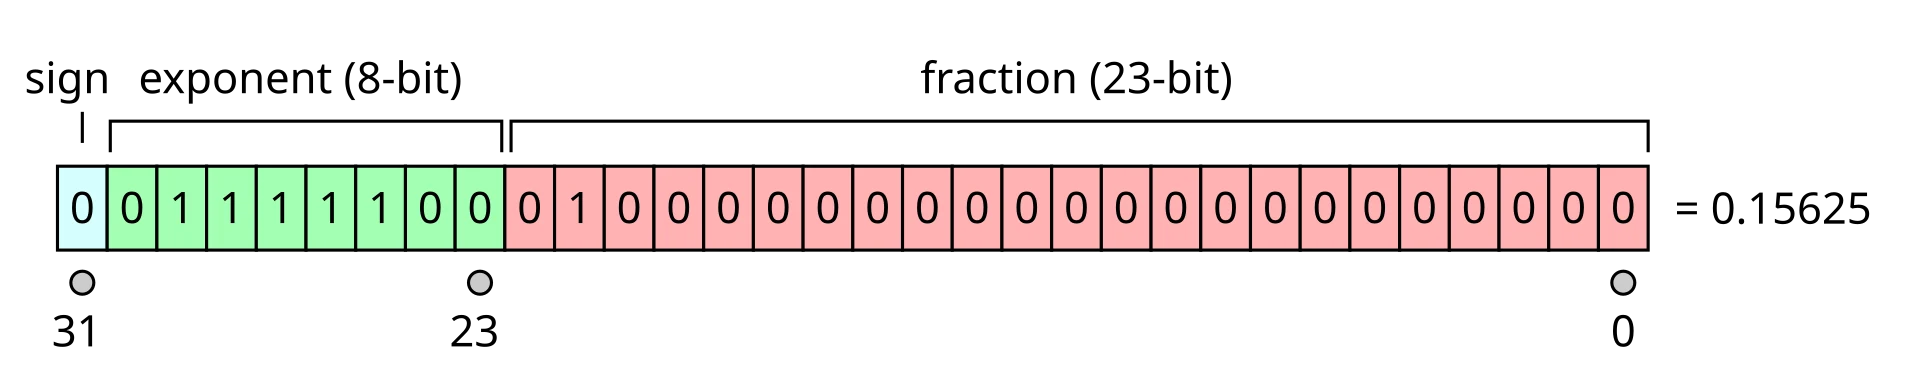
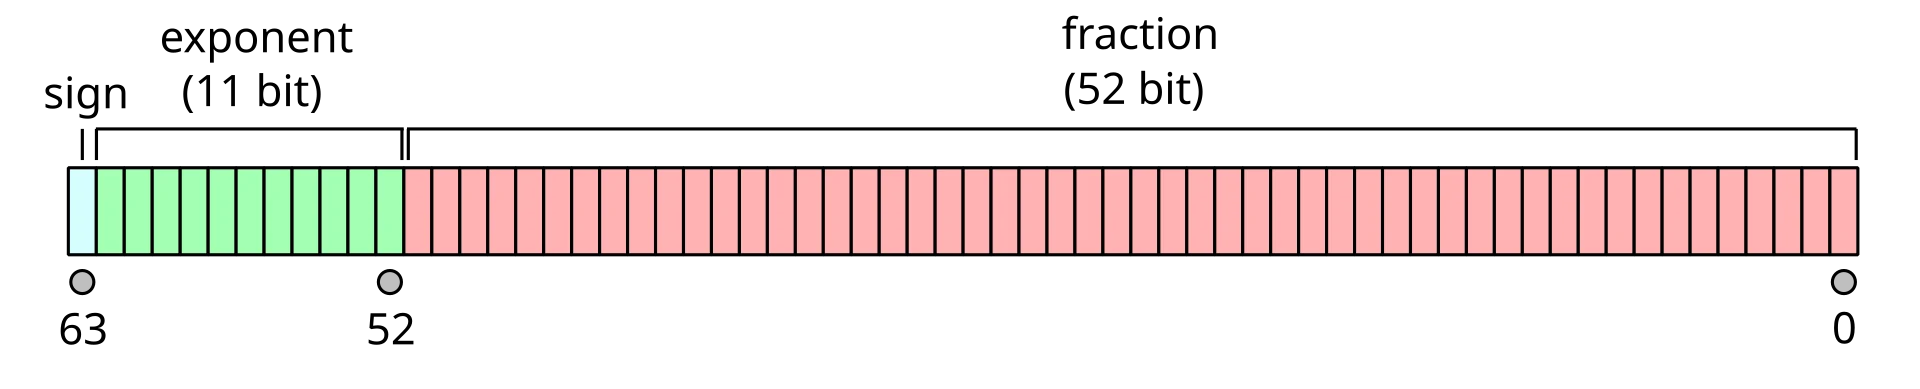
| 格式 | 总位数 | 符号 S | 阶码 E | 尾数 M | 偏置值 |
|---|---|---|---|---|---|
| 单精度 | 32 | 1 | 8 | 23 | 127 |
| 双精度 | 64 | 1 | 11 | 52 | 1023 |
规格化数的真值:N = (−1)^S × 1.M × 2^(E − 偏置),其中尾数隐含最高位 1(省一位、多一位精度)。
特殊值规定:
| E | M | 含义 |
|---|---|---|
| 全 0 | 全 0 | ±0 |
| 全 0 | 非 0 | 非规格化数(靠近 0 的微小量) |
| 全 1 | 全 0 | ±∞ |
| 全 1 | 非 0 | NaN(非数) |
例:写出 −0.5 的单精度表示。−0.5 =
−1.0 × 2^(−1),故 S=1,E = −1 + 127 = 126 =0111 1110,M = 0(1.0 的隐含位已含)。结果:1 01111110 00000000000000000000000。
2.1.5 十进制数的二进制编码(BCD)
用 4 位二进制表示一位十进制数,最常用 8421 码(如 385 → 0011 1000 0101)。BCD 便于与人交互,但比纯二进制浪费约 1/6 的编码空间,且运算需专门的"十进制调整"。
2.2 字符型数据的表示
① ASCII 码:7 位编码(常用 8 位存储,最高位作校验或扩展)。记住锚点:'0' = 48 = 30H,'A' = 65 = 41H,'a' = 97 = 61H;数字、大写、小写三段的码值递增规律常用来出选择/填空。
② 汉字编码:汉字处理要经过"输入码 → 机内码 → 字形码"的转换,关键是三个编码的关系:
- 区位码:把汉字按 94×94 的二维表定位(区号 + 位号);
- 国标码:
国标码 = 区位码 + 2020H(避免与 ASCII 控制码冲突); - 机内码:
机内码 = 国标码 + 8080H(使两个字节最高位均为 1,与 ASCII 区分)。
例:已知某汉字的区位码为
2153H,则国标码 =2153H + 2020H = 4173H,机内码 =4173H + 8080H = C1F3H。反向换算时相减即可。掌握这条"两次加偏移"的链路就够应付填空与选择。
③ Unicode 与 UTF-8:Unicode 为全世界字符统一编号(码点);UTF-8 是它的变长字节实现(1~4 字节),对 ASCII 完全兼容,是当前互联网文本的主流编码。
2.3 数据处理与存储
-
字节、字与字长:1 字节 = 8 位;字通常是机器字长的整数倍;按字节编址时,一个字要占多个地址。
-
大端与小端:多字节数据在存储器中的字节序。大端(Big-endian)把高位字节放在低地址;小端(Little-endian)把低位字节放在低地址。x86 用小端。
例:32 位数
0x12345678存放在地址 1000H 起。大端:12 34 56 78;小端:78 56 34 12。 -
边界对齐:为了访存效率,通常要求字的起始地址是字长的整数倍;不对齐会导致一次访问跨越两个存储字(需两次访存)。
-
堆栈:后进先出(LIFO),由栈指针 SP 指示栈顶;按生长方向分"向低地址生长"(x86)与"向高地址生长"。
2.4 基本运算方法
2.4.1 定点加减法
补码加减公式(连同符号位一起运算):
[X + Y]补 = [X]补 + [Y]补,[X − Y]补 = [X]补 + [−Y]补(其中 [−Y]补 为"连同符号位取反加一")。
溢出判断三种方法(都要求掌握):
- 单符号位法:两个同号数相加,结果符号与之相反 → 溢出;
- 双符号位法(变形补码):用
00/11表示正/负,运算后01为正溢、10为负溢; - 进位判断法:设符号位进位为
Cf、最高数值位进位为Cn,则Cf ⊕ Cn = 1表示溢出。
2.4.2 移位运算
| 类型 | 规则 | 用途 |
|---|---|---|
| 算术移位 | 左移补 0;右移时补码补符号位(保持正负) | 乘除 2 的幂 |
| 逻辑移位 | 无论左右一律补 0 | 无符号数 / 位操作 |
| 循环移位 | 移出的位补到另一端(分带进位与不带进位) | 位检测、加密 |
例:8 位补码
1100 1000表示 −56。算术右移一位 →1110 0100(高位补符号位 1),其值为 −28(恰好是 −56 ÷ 2),可见算术右移等价于"除以 2 并向下取整"。若换成逻辑右移,高位补 0 会得到0110 0100= +100,正负号被破坏——这正是补码必须用算术移位的原因。
2.4.3 定点乘法
① 原码一位乘:符号位单独处理(异或),数值部分按无符号数"逐位乘、累加、右移"。部分积与乘数一起右移一位。
例:
x = 0.1101,y = 0.1011,求x·y。 符号 = 0⊕0 = 0(正)。数值部分:被乘数 M = 1101,乘数 Q = 1011,部分积 A 初值 0000。
| 步骤 | 判断与操作 | A(部分积) | Q(乘数) |
|---|---|---|---|
| 初始 | — | 0000 | 1011 |
| 1 | Q₀=1:A←A+M,右移一位 | 0110 | 1101 |
| 2 | Q₀=1:A←A+M,右移一位 | 1001 | 1110 |
| 3 | Q₀=0:只右移一位 | 0100 | 1111 |
| 4 | Q₀=1:A←A+M,右移一位 | 1000 | 1111 |
乘积 = A:Q =
1000 1111,即 x·y = 0.10001111(可验证:13/16 × 11/16 = 143/256 ✓)。
② 补码一位乘(Booth 算法):可直接对补码运算,无需先取绝对值。规则:根据乘数相邻两位 (yᵢ, yᵢ₊₁)(最低位右侧补 0)判断:
| (yᵢ, yᵢ₊₁) | 操作 |
|---|---|
| 00 或 11 | 部分积 +0 |
| 01 | 部分积 +[X]补 |
| 10 | 部分积 +[−X]补 |
每步做完后部分积与乘数算术右移一位。
例:
[X]补 = 1011(−5),[Y]补 = 0011(+3),求 X·Y。[−X]补 = 0101,A 初值 0000,Q = 0011,附加位 = 0。
| 步骤 | (Q₀, 附加位) | 操作 | A | Q |
|---|---|---|---|---|
| 初始 | — | — | 0000 | 0011 |
| 1 | (1, 0) → −X | A←A+[−X]=0101,算术右移 | 0010 | 1001 |
| 2 | (1, 1) → +0 | 算术右移 | 0001 | 0100 |
| 3 | (0, 1) → +X | A←A+[X]=1100,算术右移 | 1110 | 0010 |
| 4 | (0, 0) → +0 | 算术右移 | 1111 | 0001 |
结果 A:Q =
1111 0001= −15 ✓(−5 × 3 = −15)。注意右移是算术右移(补符号位)。
2.4.4 定点除法
原码除法:符号位单独异或,数值部分用"左移一位 → 与除数比较 → 上商 → 相减"的循环。两种实现:
- 恢复余数法:先做减法,若余数为负,则恢复余数(加回除数)再上商 0;
- 加减交替法(不恢复余数法):当余数为正,上商 1,下一步减除数;当余数为负,上商 0,下一步加除数(省去恢复步骤),效率更高。
例:
x = 0.1010(0.625),y = 0.1100(0.75),求x ÷ y(保留 4 位商)。 每次循环:余数左移一位,减去除数y,看符号上商。
| 步骤 | 2R | 比较与相减 | 商位 | 新余数 R |
|---|---|---|---|---|
| 1 | 1.0100 | 1.25 ≥ 0.75 | 1 | 0.1000(0.5) |
| 2 | 1.0000 | 1.0 ≥ 0.75 | 1 | 0.0100(0.25) |
| 3 | 0.1000 | 0.5 < 0.75 | 0 | 0.1000(0.5) |
| 4 | 1.0000 | 1.0 ≥ 0.75 | 1 | 0.0100(0.25) |
商 =
0.1101(0.8125),余数 =0.0100;验证:0.1101 × 0.1100 + 0.0100 × 2⁻⁴ = 0.609375 + 0.015625 = 0.625✓(等于被除数)。
2.4.5 浮点加减运算
五步流程(顺序固定):
- 对阶:小阶向大阶看齐(小阶的尾数右移,阶差多少移多少),避免大数"吃掉"小数;
- 尾数运算:对阶后按定点数加减;
- 规格化:把结果尾数调整为规格化形式(可能要左规或右规);
- 舍入:处理移位丢掉的位(0 舍 1 入法、恒置 1 法等);
- 溢出判断:检查阶码是否超出表示范围(上溢为真溢出,下溢按机器零处理)。
2.4.6 算术逻辑单元 ALU
ALU 是运算器的核心,完成算术运算(加、减、乘、除)、逻辑运算(与、或、非、异或)与移位。它的两个关键参数是字长(数据通路宽度)与功能选择(由控制器给出)。
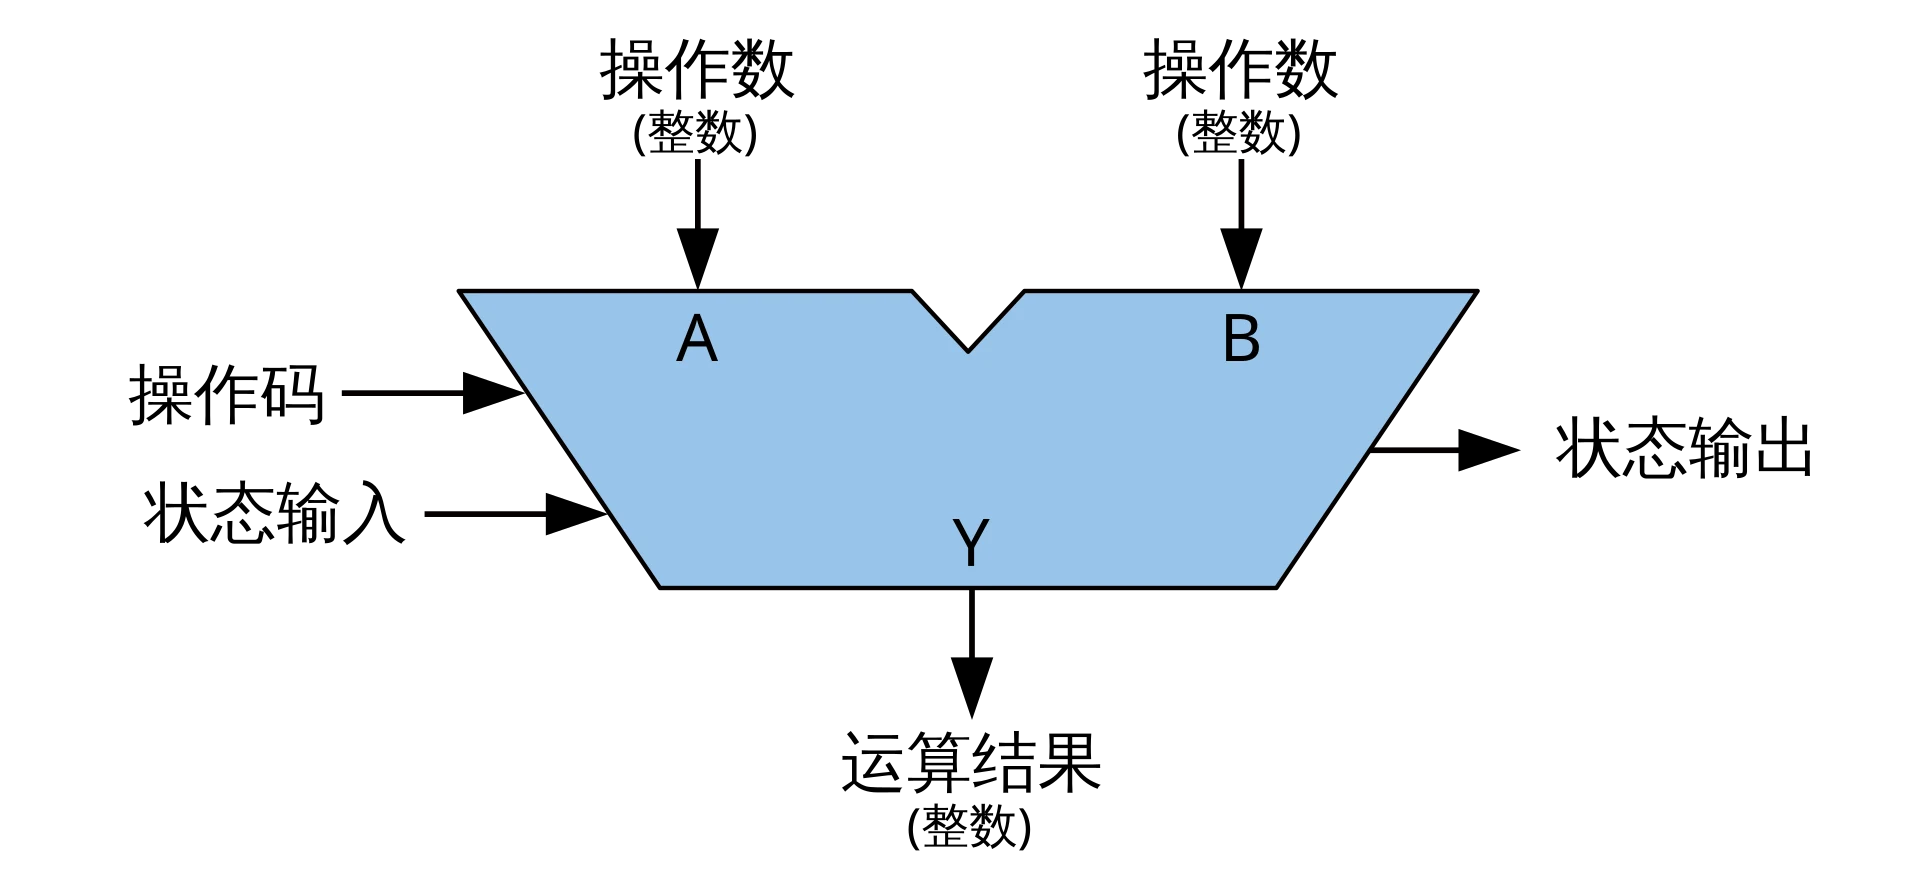
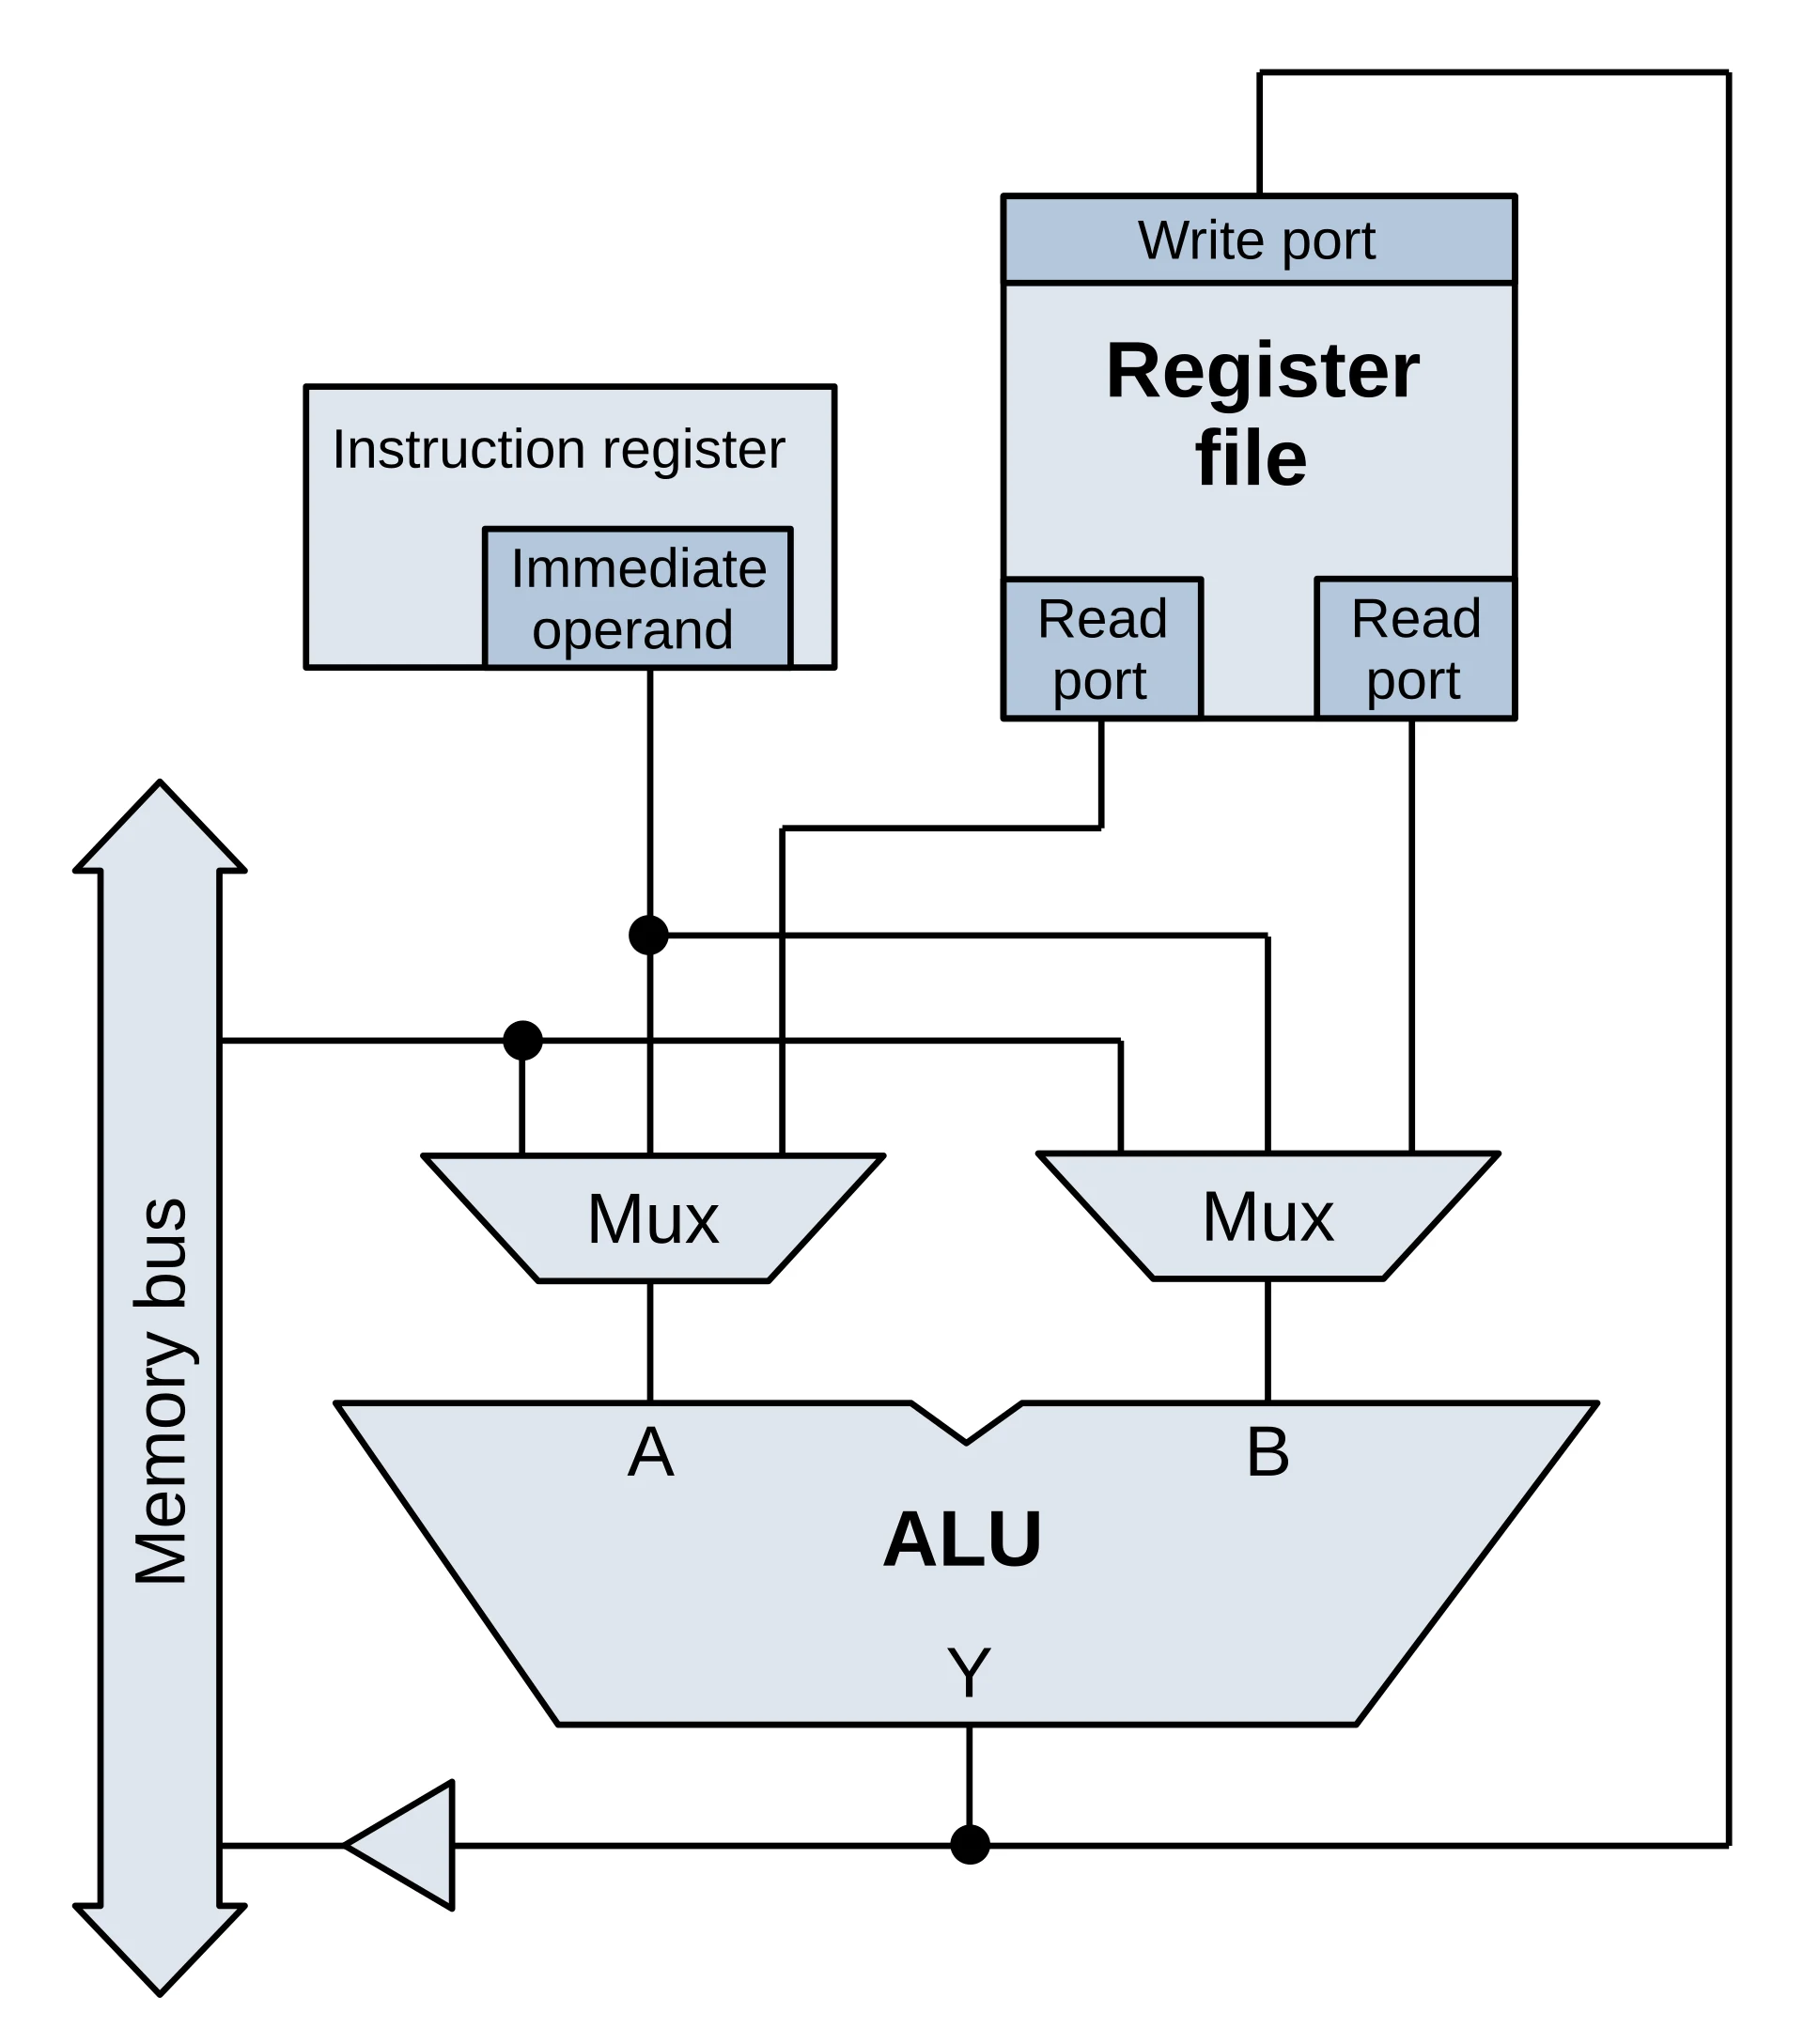
加法器的进位链是速度瓶颈:串行(逐位)进位简单但慢;并行进位(先行进位)用进位产生/传递函数一次算出各位进位,速度快但电路复杂,实际常采用组内并行、组间串行/并行的混合结构(如 74181 芯片把 4 位 ALU 与先行进位集成在一起)。
2.5 常用的数据校验方法
码距:任意两个合法编码之间最少不同的位数,记为 d。它能检出的错误位数 e 与可纠正的错误位数 t 满足 d ≥ e + t + 1:
| d | 能力 |
|---|---|
| 1 | 无检错能力 |
| 2 | 可检出 1 位错(奇偶校验) |
| 3 | 可检出 2 位错或纠正 1 位错(海明码) |
| 4 | 可纠 1 位错并检出 2 位错(扩展海明码) |
① 奇偶校验:附加 1 位,使整个编码中 1 的个数为奇数(奇校验)或偶数(偶校验)。只能发现奇数个错误,无法纠错,也无法发现偶数个错误。
② 海明校验:设数据 k 位、校验 r 位,须满足 2^r ≥ k + r + 1。校验位插在编号为 2^0, 2^1, 2^2 … 的位置上,每个校验位负责"其覆盖范围内各数据位的异或和"。
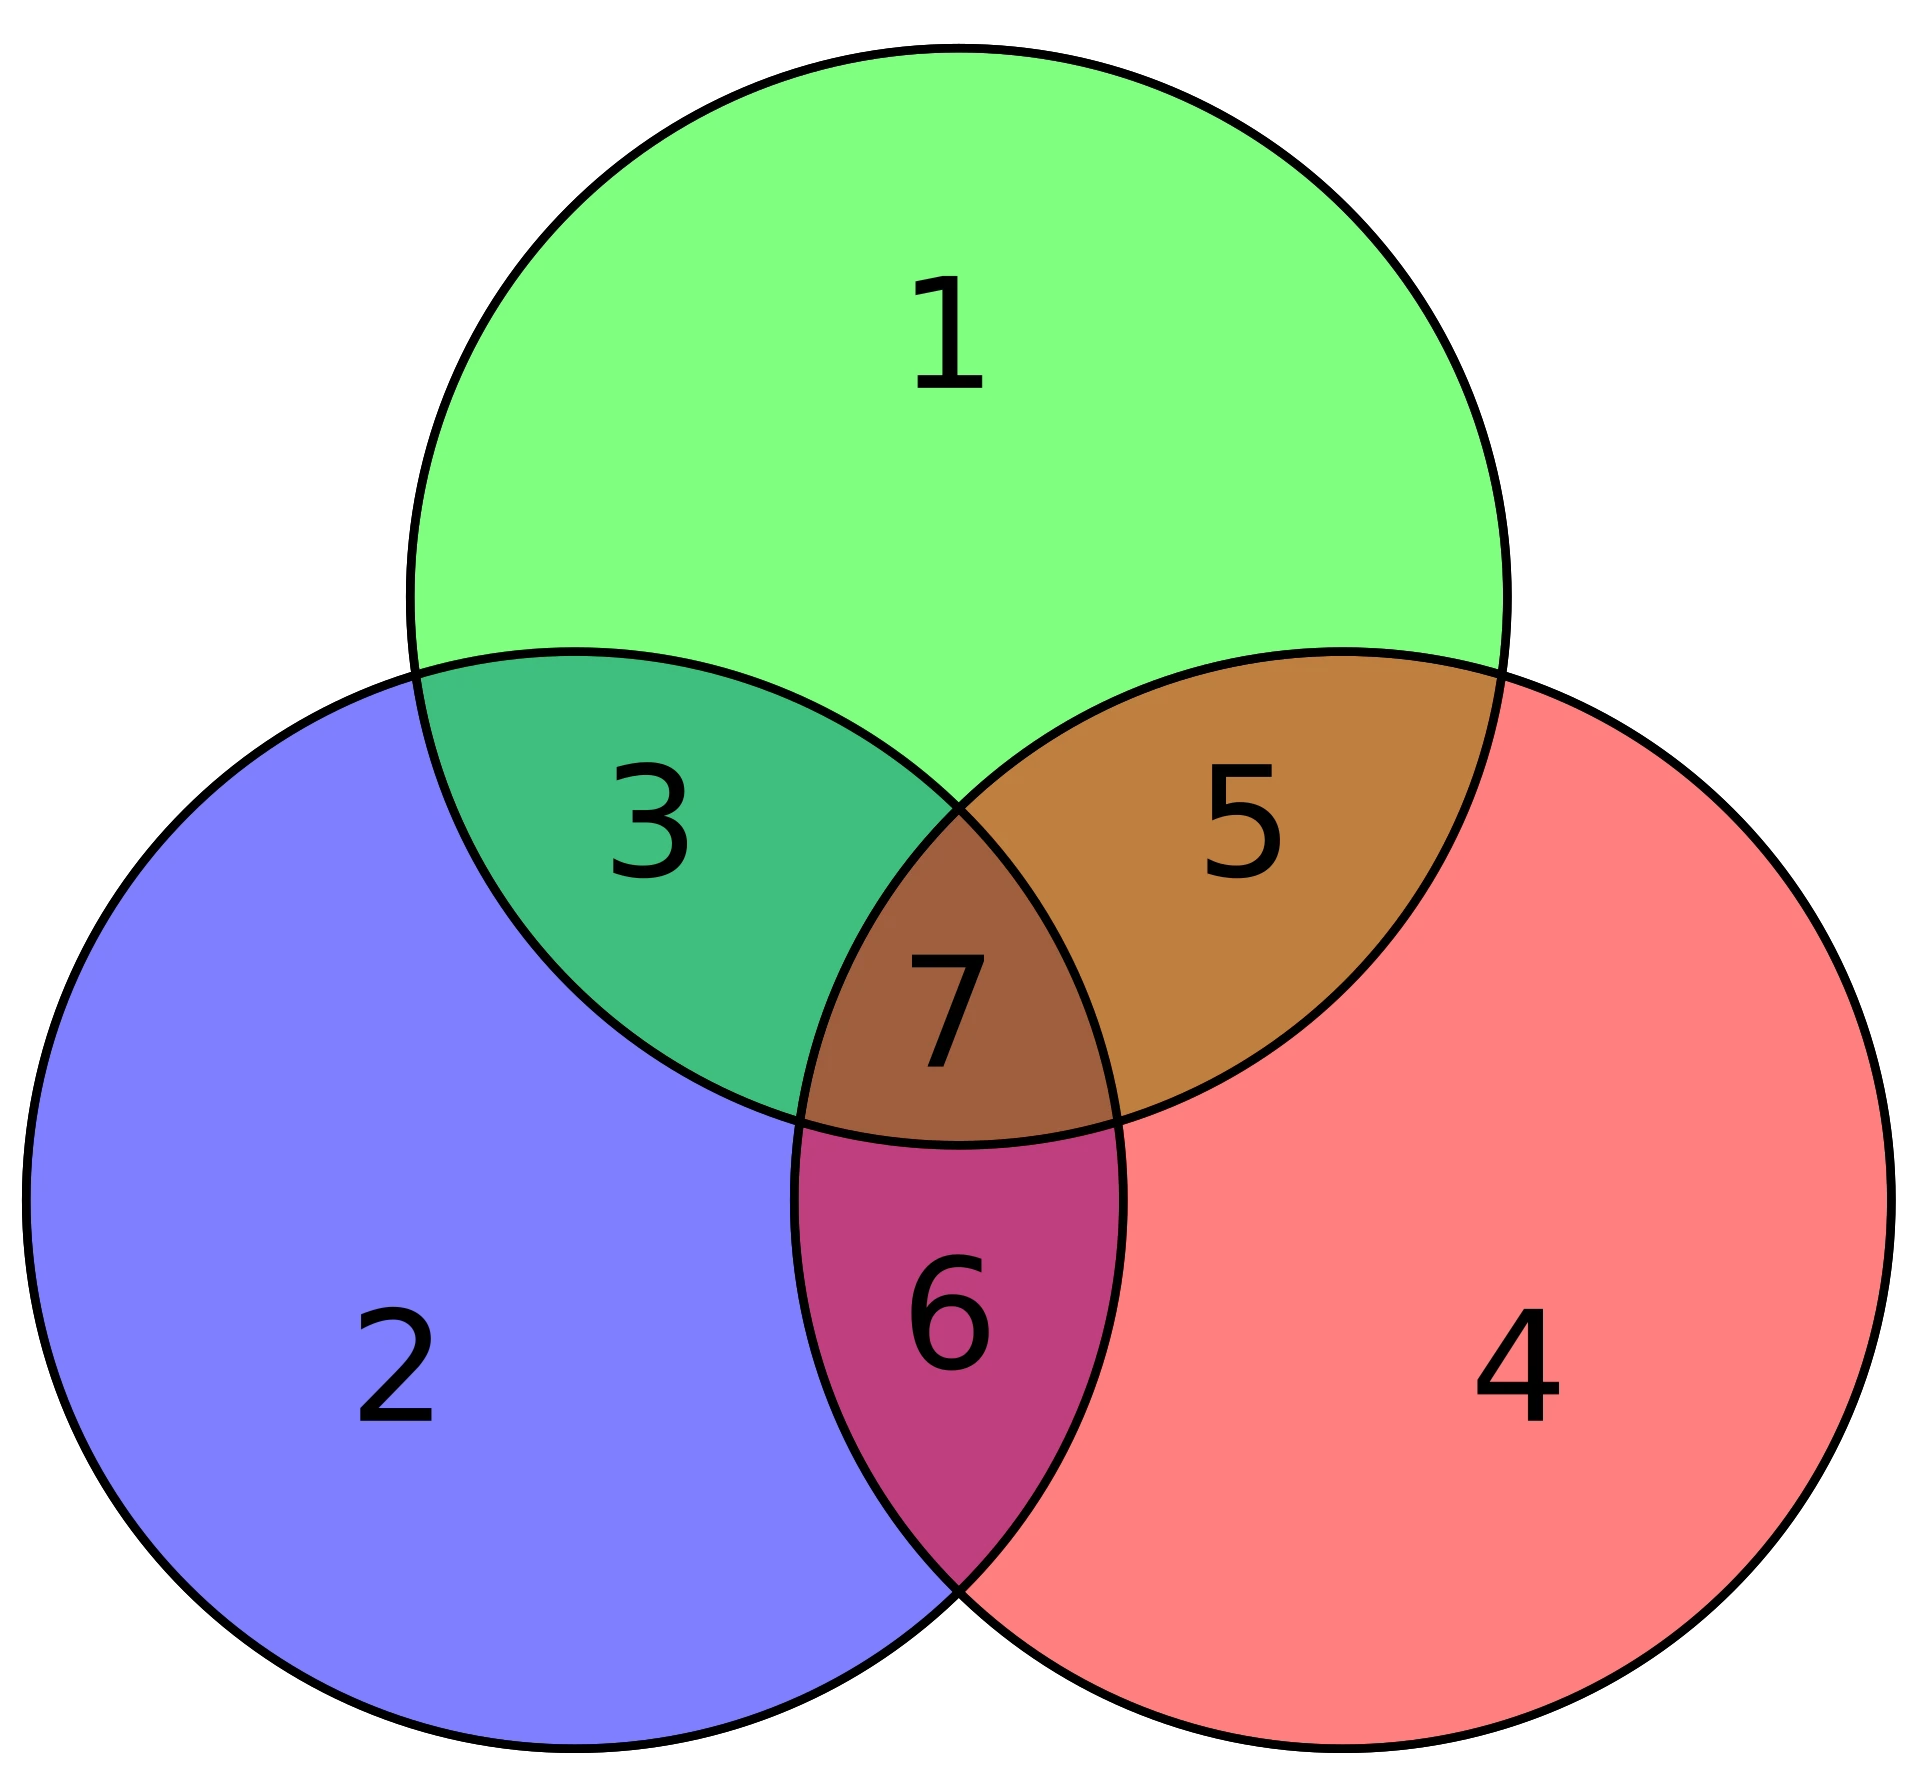
例(Hamming(7,4)):数据
d = 1010,按位置 3、5、6、7 放置。偶校验: p1 覆盖位 1,3,5,7 → p1 = 1;p2 覆盖位 2,3,6,7 → p2 = 0;p4 覆盖位 4,5,6,7 → p4 = 1。 编码为p1 p2 d1 p4 d2 d3 d4 = 1011010。若接收端收到1001010,三组校验和的组合 = 3,即第 3 位出错,取反即可纠正。
③ CRC 循环冗余校验:用于数据链路层、磁盘等,检错能力强。用生成多项式 G(x) 对数据做模 2 除法(异或,无借位),余数接到数据后面发送;接收端再除一次,余数非 0 判错。
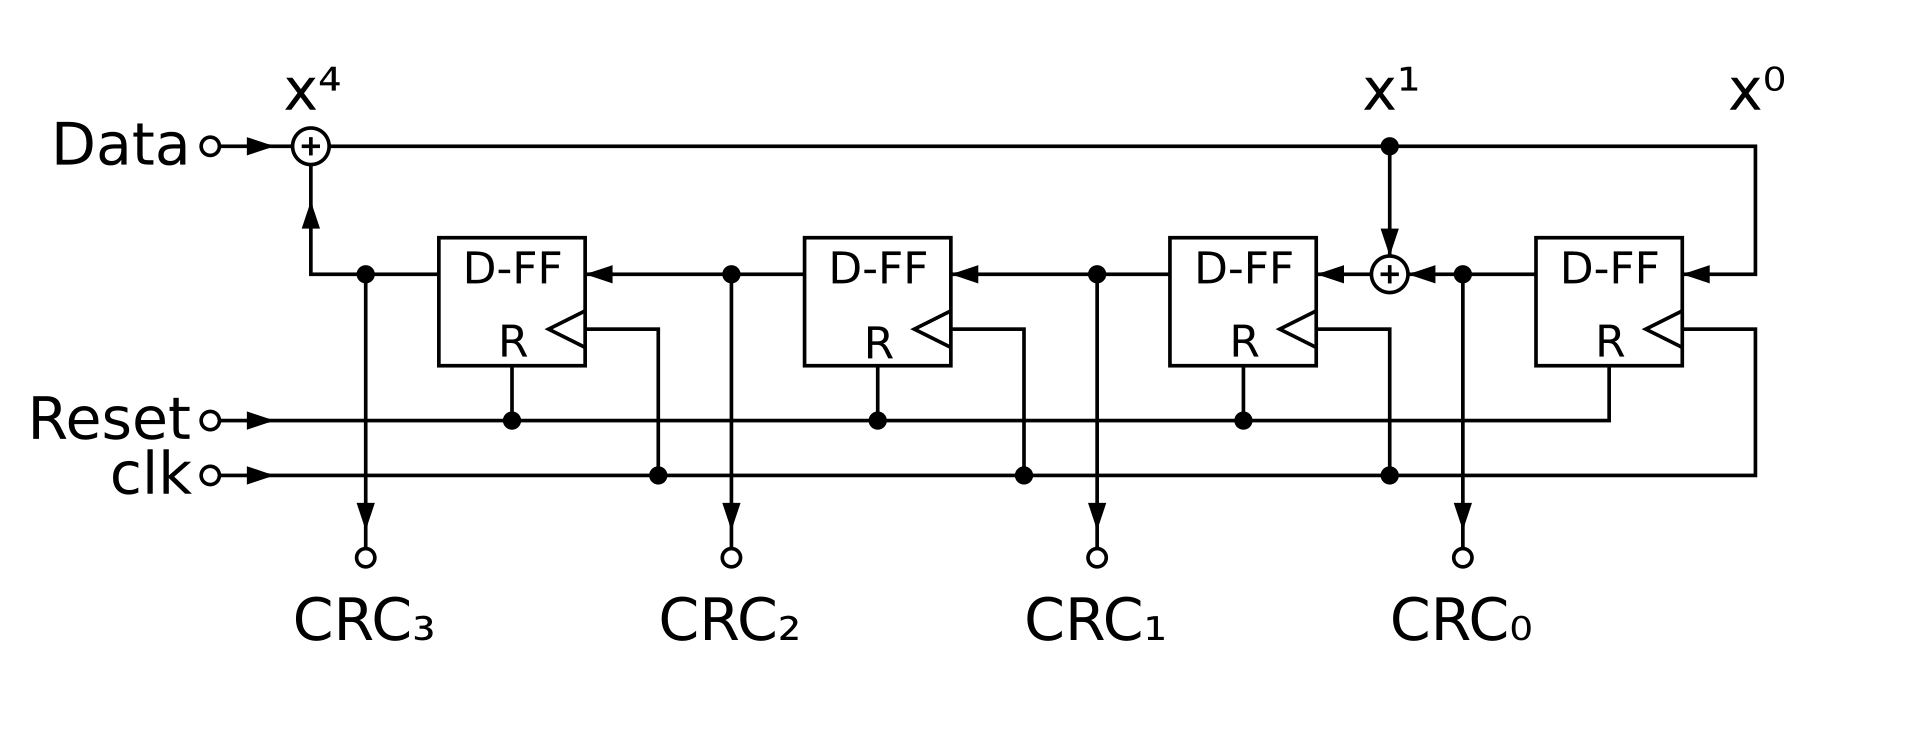
例:数据
101001,G(x) = x³ + x² + 1→ 除数1101(r = 3)。数据后补 3 个 0 得101001000,模 2 除以 1101 得余数001,发送101001001。
2.6 典型题
题 1:写出 −52 的 8 位原码、反码、补码、移码。52 = 0011 0100。
解:原码 1011 0100;反码 1100 1011;补码 1100 1100;移码 = 补码符号位取反 = 0100 1100。
题 2:用 8 位双符号位判断 [X]补 = 01 1010 0011 与 [Y]补 = 01 0101 1101 相加是否溢出。
解:取低 8 位运算:1010 0011 + 0101 1101 = 1 0000 0000 → 结果 0000 0000,双符号位为 00,无溢出(实际为 −93 + 93 = 0)。
题 3:一个 32 位浮点数采用 IEEE 754 单精度,求它表示 1.0 的阶码字段值。
解:1.0 = 1.0 × 2^0,E = 0 + 127 = 127 = 0111 1111。
题 4:数据 8 位,采用海明码纠一位错,至少需要多少位校验位?
解:求最小 r 使 2^r ≥ 8 + r + 1:r = 4 时 16 ≥ 13 成立,故需 4 位。
更多练习:见附录 C 自测清单。
3. 第 3 章 CPU 子系统(重点章)
本章回答"硬件怎么被指挥干活"。主线:指令是什么 → 运算器怎么组织 → 控制器怎么发号施令 → 一条指令怎么走完 → 怎么让多条指令并行。
3.1 CPU 概述
CPU 的四大功能:
| 功能 | 含义 |
|---|---|
| 指令控制 | 保证指令按程序规定的顺序执行(首要任务) |
| 操作控制 | 产生并发出各种操作信号,管理各部件动作 |
| 时间控制 | 对各类操作实施定时(节拍) |
| 数据加工 | 完成算术与逻辑运算(根本任务) |
CPU 的组成:运算器 + 控制器 + 寄存器组(现代还集成 Cache、总线接口、中断系统等)。
必须熟记的寄存器与其作用:
| 寄存器 | 全称 | 作用 |
|---|---|---|
| PC | 程序计数器 | 存放下一条要执行指令的地址,取指后自动加 1 |
| IR | 指令寄存器 | 存放当前正在执行的指令,供译码 |
| MAR | 存储器地址寄存器 | 存放 CPU 要访问的主存单元地址 |
| MDR | 存储器数据寄存器 | 暂存读出/写入主存的数据 |
| AC | 累加器 | 存放运算的中间与最终结果 |
| PSW | 程序状态字 | 存放标志位:进位 C、溢出 V、零 Z、负号 N 等 |
| R0~Rn | 通用寄存器 | 暂存操作数与中间结果,减少访存 |
3.2 指令系统
3.2.1 指令格式与操作码编码
一条指令由**操作码(做什么)和地址码(对谁做)**组成。按地址码个数分为零地址、一地址、二地址、三地址指令。
定长操作码:操作码位数固定,译码简单,但编码空间浪费;扩展操作码:短操作码的前缀留给长操作码使用,可在有限位数下表达更多指令,代价是译码复杂。
扩展操作码的核心规则:任一短操作码都不能是另一操作码的前缀(否则译码有歧义)。
例:指令字长 16 位,每个地址码 4 位。要求三地址指令 15 条、二地址指令最多、一地址指令最多,怎么分配? 操作码最高 4 位共 16 个编码,三地址用去 15 个,剩 1 个编码留给更长的操作码;该编码再加一个 4 位地址码可扩展出
2^4 = 16个二地址操作码;若二地址用去 n 个,剩余16 − n个可再各扩展出 16 个一地址操作码。所以三地址越多、长指令能分到的编码越少,这是一道经典填空题。
3.2.2 寻址方式
寻址方式决定"地址码 A 怎样变成有效地址 EA"或"操作数在哪里":
| 寻址方式 | 操作数/有效地址 | 访存次数 | 典型用途 |
|---|---|---|---|
| 立即寻址 | 操作数 = A(在指令中) | 0 | 常量 |
| 直接寻址 | EA = A | 1 | 访问固定单元 |
| 间接寻址 | EA = (A) | 2 次以上 | 指针 |
| 寄存器寻址 | 操作数 = (Ri) | 0 | 高频操作数 |
| 寄存器间接 | EA = (Ri) | 1 | 指针/数组 |
| 相对寻址 | EA = (PC) + A | 1 | 转移指令 |
| 基址寻址 | EA = (基址寄存器) + A | 1 | 程序重定位(面向系统) |
| 变址寻址 | EA = (变址寄存器) + A | 1 | 数组遍历(面向用户) |
记忆口诀:基址面向"系统"(多道程序、程序浮动),变址面向"用户"(循环、数组);相对寻址的基准是"取指结束后的 PC"——后者是最常见的失分点。
3.2.3 指令类型
数据传送(MOV、LOAD、STORE)、算术逻辑运算(ADD、AND)、移位、转移(条件/无条件)、输入输出、系统控制(停机、访管)。按地址码个数又能分为零地址(如空操作 NOP)、一地址、二地址、三地址指令。
3.2.4 CISC 与 RISC
| 维度 | CISC(复杂指令集) | RISC(精简指令集) |
|---|---|---|
| 指令数量 | 多且复杂 | 少而精 |
| 指令长度 | 变长 | 定长 |
| 寻址方式 | 多 | 少 |
| 访存限制 | 多数指令可直接访存 | 只有 load/store 能访存 |
| 通用寄存器 | 较少 | 多 |
| 控制器实现 | 多为微程序 | 多为硬布线 |
| 指令周期 | 差异大,多为不定长 | 大多单周期,便于流水 |
| 代表 | x86 | MIPS、ARM、RISC-V |
3.2.5 MIPS32 指令格式
MIPS32 采用 32 位定长指令、32 个通用寄存器($0 恒为 0),只有 lw/sw 访存,是典型的 RISC。三类格式:
| 类型 | 位段划分(31→0) | 用途 |
|---|---|---|
| R 型 | op(6) | rs(5) | rt(5) | rd(5) | shamt(5) | funct(6) | 寄存器间运算(add、sub、and…) |
| I 型 | op(6) | rs(5) | rt(5) | immediate(16) | 立即数运算、访存、条件分支 |
| J 型 | op(6) | address(26) | 无条件跳转 |
例:
add $t0, $t1, $t2的语义是$t0 ← $t1 + $t2,属于 R 型,op = 000000,功能由funct区分。分支指令beq属 I 型,16 位立即数是相对 PC 的偏移量(需左移 2 位),这解释了为什么"相对寻址"在 MIPS 中如此常见。
3.3 运算部件与运算器组织
3.3.1 运算器的基本部件
运算器 = ALU + 寄存器组 + 多路选择器 + 移位器 + 内部总线。
-
寄存器组:多读端口/单写端口,是运算器与指令打交道的"操作数池"。寄存器堆的读写由地址译码与使能信号控制:
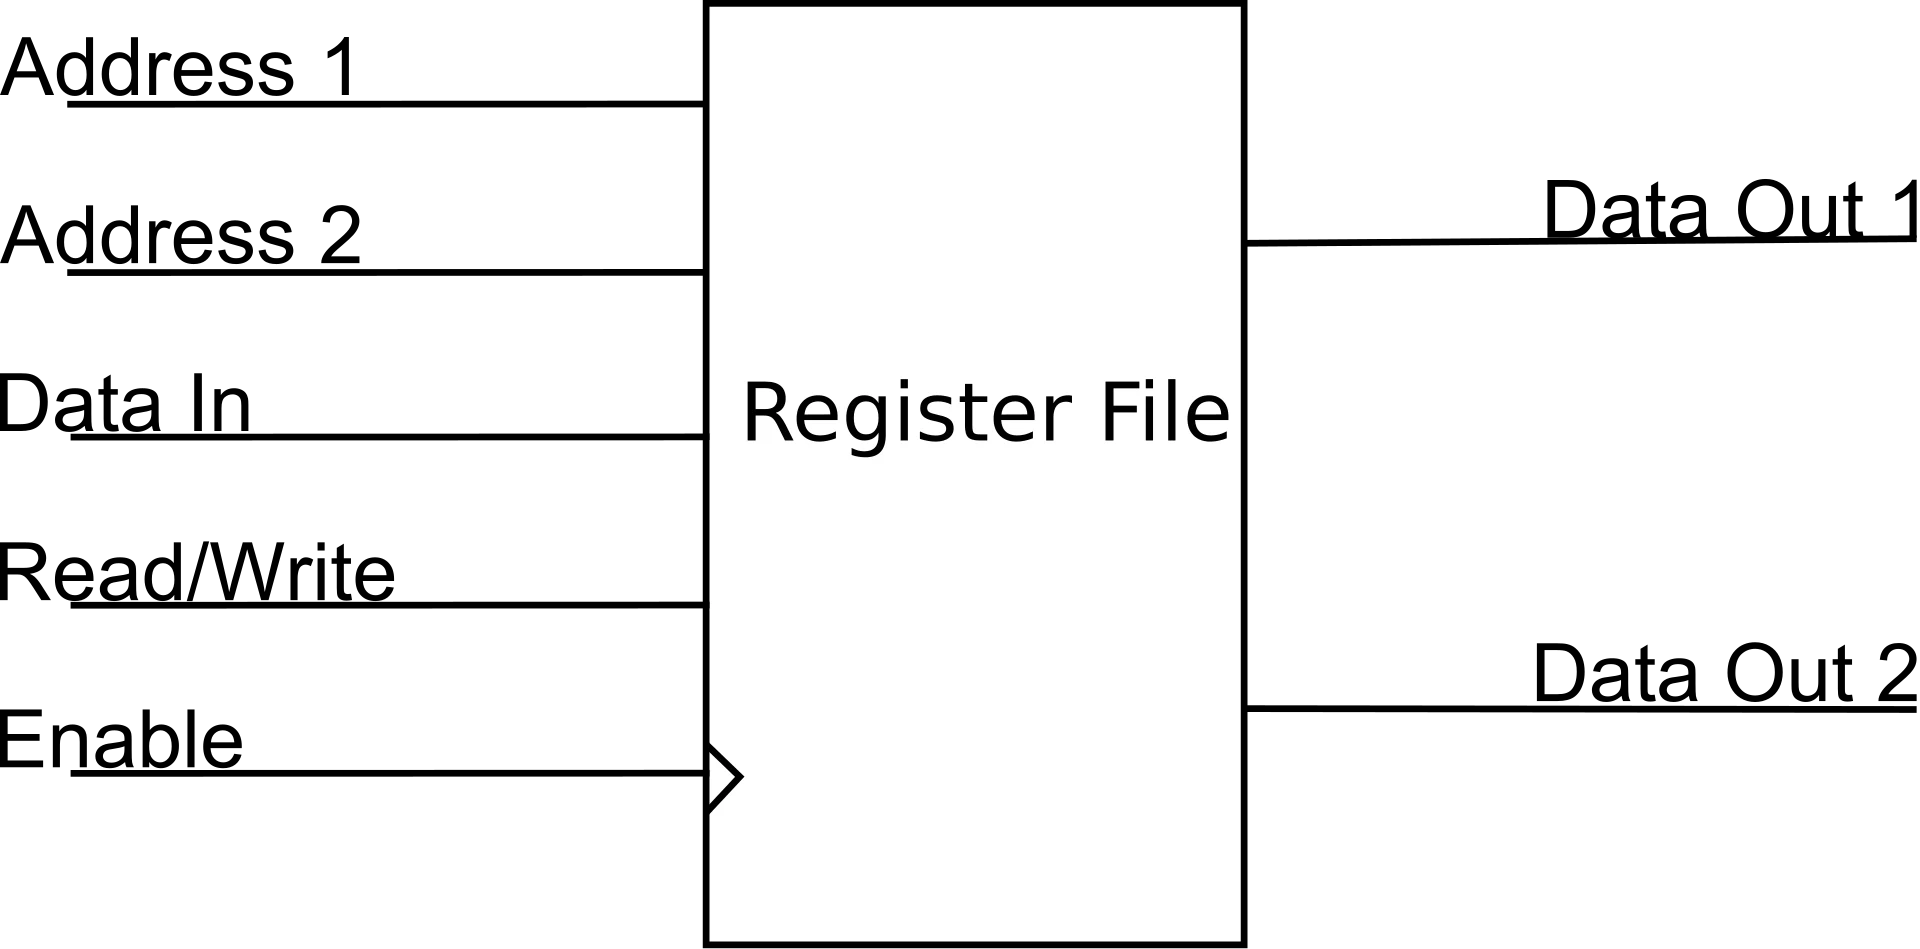
-
移位器:桶形移位器(Barrel Shifter)用多级多路选择器实现"任意位数移位",一次即可完成,避免逐位移位耗费多个节拍:
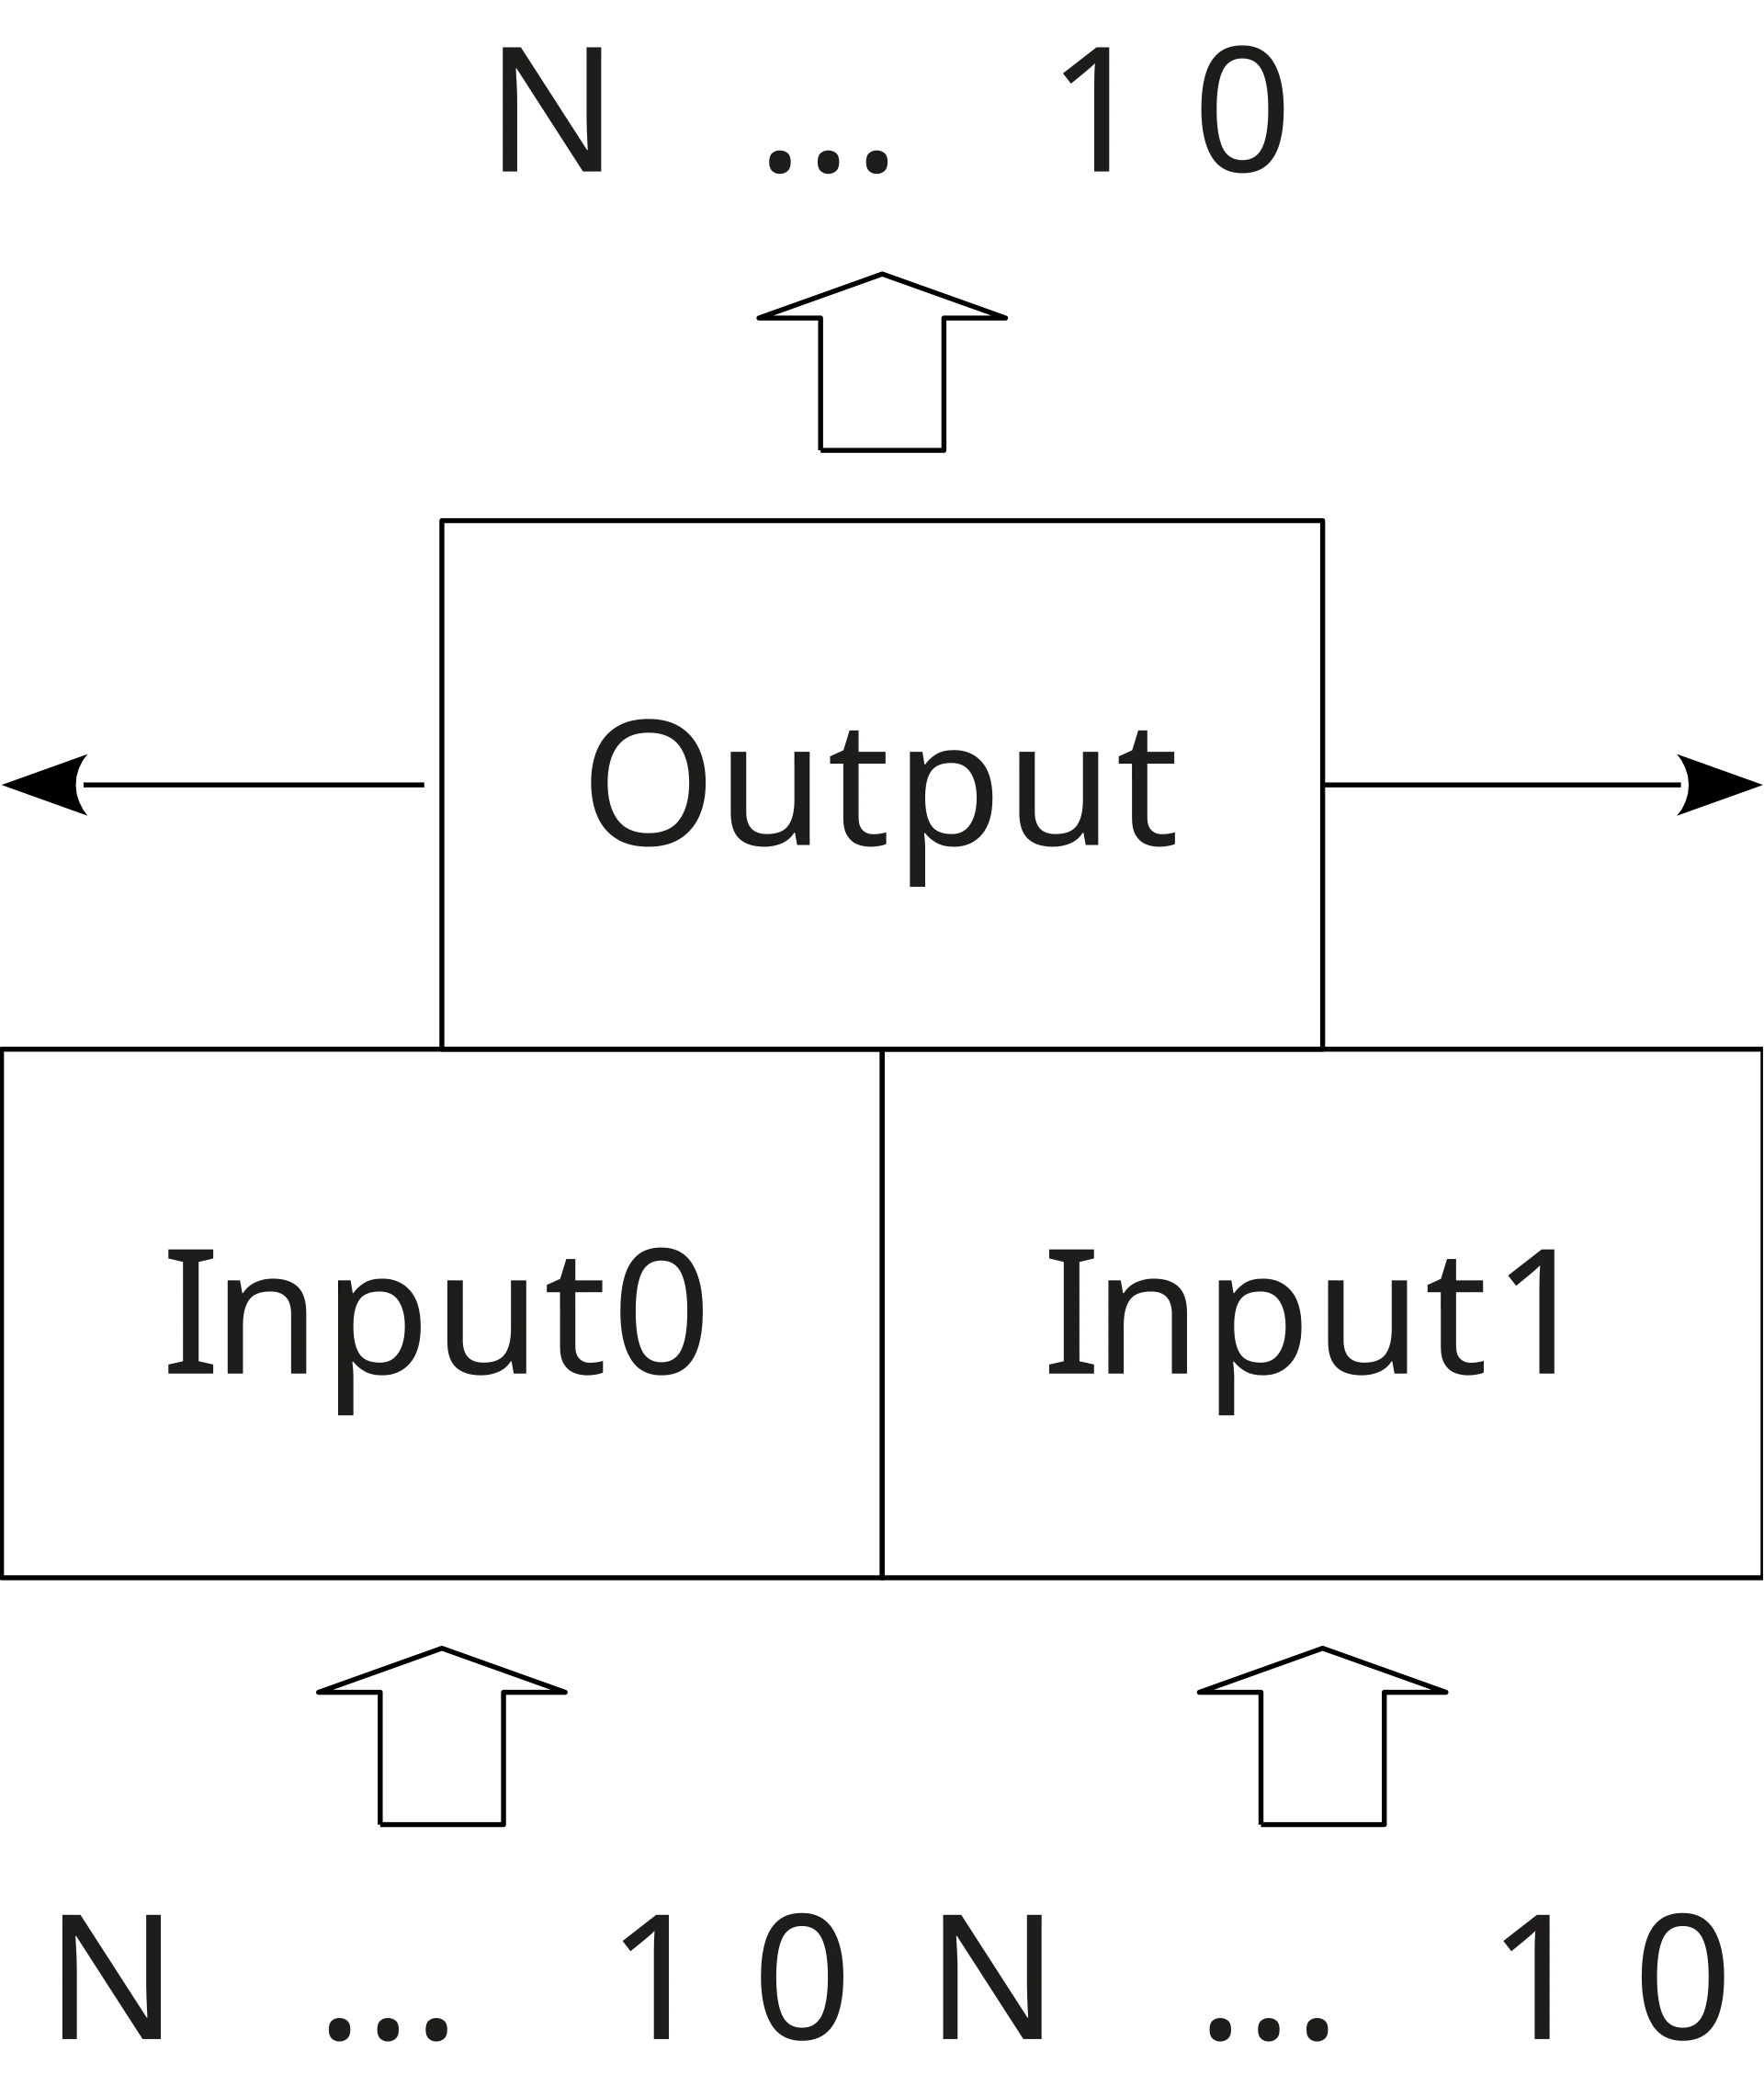
-
ALU:见第 2 章。运算器的字长即数据通路宽度,直接决定机器字长。
3.3.2 运算器的组织:单总线、双总线、三总线
运算器内部各部件靠内部总线交换数据。同一时刻只允许一个部件向总线发送数据,因此总线越少,一条运算指令需要的节拍越多:
| 组织方式 | 一条 R3 ← R1 + R2 的节拍数 | 特点 |
|---|---|---|
| 单总线 | 3 拍(R1→Y;R2 与 Y 经 ALU→Z;Z→R3) | 结构最简单,速度最慢 |
| 双总线 | 2 拍 | 折中 |
| 三总线 | 1 拍 | 最快,硬件最复杂 |
3.3.3 单总线 CPU 数据通路与"一条指令的硬件动作"
下图是教材反复使用的经典数据通路:所有寄存器、MAR、MDR、ALU 的输入/输出都挂在同一条内部总线上。
以执行 ADD R1, R2, R3(语义 R3 ← R1 + R2)为例,逐拍写出微操作与控制信号:
| 节拍 | 微操作 | 控制信号(选通) | 说明 |
|---|---|---|---|
| T1 | R1 → Y | R1out、Yin | 把第 1 个操作数送入 ALU 的暂存器 Y |
| T2 | R2 → ALU,ALU 完成 Y + R2 → Z | R2out、ALU_ADD、Zin | 第 2 个操作数经总线直达 ALU 输入 |
| T3 | Z → R3 | Zout、R3in | 运算结果写回目的寄存器 |
关键约束:T2 中"R2 送上总线"与"ALU 输出到 Z"不能同时占用总线——总线一次只服务一个数据源,所以 ALU 的输出必须先进暂存器 Z,下一拍再写入寄存器。理解这一条,就理解了"为什么单总线结构要多拍完成一条指令"。
若把 ADD 换成 LOAD R1, (R2)(取数),则微操作为:
| 节拍 | 微操作 | 说明 |
|---|---|---|
| T1 | R2 → MAR | 地址送地址寄存器 |
| T2 | M → MDR,读主存 | 主存把数据送到数据寄存器 |
| T3 | MDR → R1 | 数据写入目的寄存器 |
| T4 | PC → MAR,读主存,MDR → IR,PC + 1 → PC | 取指公共操作(通常在取指周期完成) |
3.4 控制器
控制器的任务:根据指令的操作码、时序与状态标志,产生一组有序的控制信号。有两种实现路线。
3.4.1 硬布线控制器(组合逻辑控制器)
用组合逻辑电路直接由"操作码 + 时序 + 状态条件"产生控制信号。设计步骤:根据指令功能画出数据通路 → 列出每拍的微操作 → 归纳各操作的操作时间表 → 写出每个控制信号的逻辑表达式 → 化简并用门电路实现。
优点:速度快(信号延迟小),适合 RISC 与定长指令。缺点:设计繁琐、修改困难(改一条指令可能牵动全局),不灵活。
3.4.2 微程序控制器
把每条机器指令对应成一段微程序(存放在只读的控制存储器 CM 中),执行时逐条取出微指令并发出微命令。
核心概念层级关系(必背):
机器指令 ⊃ 微程序 ⊃ 微指令 ⊃ 微命令 一条机器指令 = 一段微程序;一条微指令 = 若干微命令(控制信号)+ 顺序控制信息(下地址)。
微指令的编码方式:
| 方式 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 直接编码(水平型) | 每一位对应一个微命令 | 速度最快、并行能力强 | 微指令字长很长 |
| 字段直接编码 | 互斥的微命令分成字段、每字段译码 | 字长显著缩短 | 需译码,稍慢 |
| 字段间接编码 | 字段的含义再由另一字段解释 | 进一步缩短 | 译码更慢、更复杂 |
按微指令字长与并行能力,又分水平型微指令(并行能力强、微程序短)与垂直型微指令(类似机器指令、并行能力弱、微程序长)。
例:某机有 32 条机器指令,每条机器指令对应 4 条微指令,微指令字长 24 位。则控制存储器 CM 至少需要
32 × 4 = 128个单元,总容量为128 × 24位。这类"算 CM 容量"的题目几乎必考。
微程序入口的形成:由指令操作码通过"微地址形成部件"映射到对应微程序的首地址(常用 PROM 或逻辑映射实现)。
两种控制器对比:
| 维度 | 硬布线 | 微程序 |
|---|---|---|
| 控制信号来源 | 组合逻辑电路 | 控制存储器中的微程序 |
| 速度 | 快 | 较慢(每拍要多读一次 CM) |
| 灵活性 | 差,改动即重新设计 | 好,改微程序即可 |
| 规整性 | 不规整 | 规整,便于设计与验证 |
| 适用 | RISC、指令少而规整 | CISC、指令多而复杂 |
3.5 指令周期与时序
三个时间尺度层层包含:
- 时钟周期(节拍):最小时间单位,
T = 1/f; - 机器周期(CPU 周期):完成一个基本操作(如一次访存)所需时间,含若干时钟周期;
- 指令周期:取出并执行一条指令的全部时间,含若干机器周期。
一条指令通常划分为四个阶段:取指周期 → 间址周期(可选)→ 执行周期 → 中断周期(可选)。
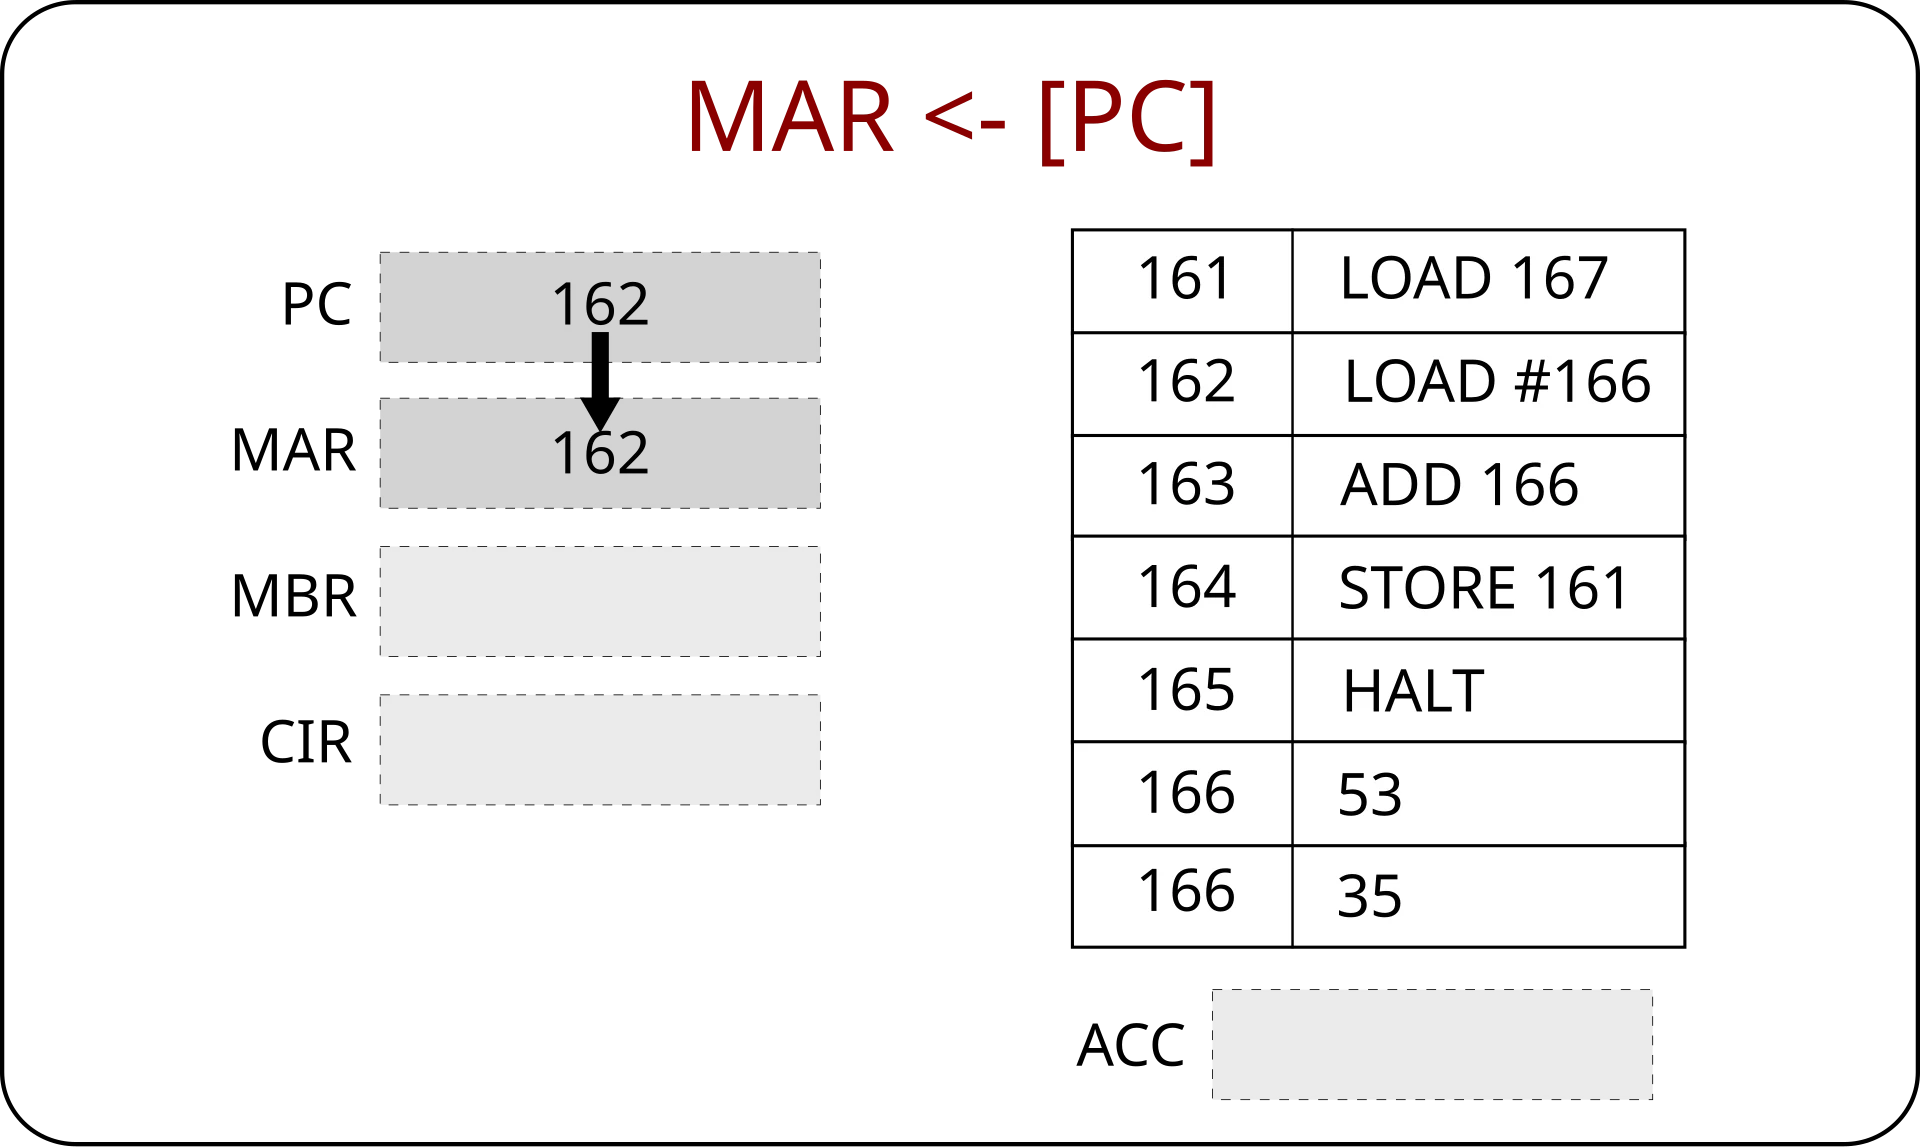
定长时序(所有指令占用相同机器周期数)控制简单但效率低;不定长时序按指令需要分配节拍,效率高但控制复杂。时序产生器负责产生节拍电位与节拍脉冲,使全机动作严格同步。
3.6 数据通路与单周期 / 多周期 CPU
单周期 CPU:每条指令都在一个时钟周期内完成,CPI = 1。代价是时钟周期必须取最长指令(通常是访存的 load)的耗时,简单指令被"陪绑",效率受限。
多周期 CPU:把一条指令分解为多个较短的时钟周期,各周期复用同一套硬件(如 ALU 既用于运算也用于算地址),CPI > 1 但时钟周期更短,整体更高效。
例:某程序指令构成为:取数/存数 20%(各需 4 拍)、算术逻辑 50%(3 拍)、分支 30%(2 拍)。求平均 CPI。
CPI = 0.2×4 + 0.5×3 + 0.3×2 = 0.8 + 1.5 + 0.6 = 2.9。若单周期实现则 CPI = 1,但时钟周期约为最慢指令的 4 拍——要比较"CPI × 时钟周期"才是真实速度,这正是本考点的陷阱。
3.7 指令流水线
3.7.1 原理与时空图
把一条指令的执行分解为若干级(经典五级:IF 取指 → ID 译码 → EX 执行 → MEM 访存 → WB 写回),让不同指令同时处于不同的级上,就像装配流水线:
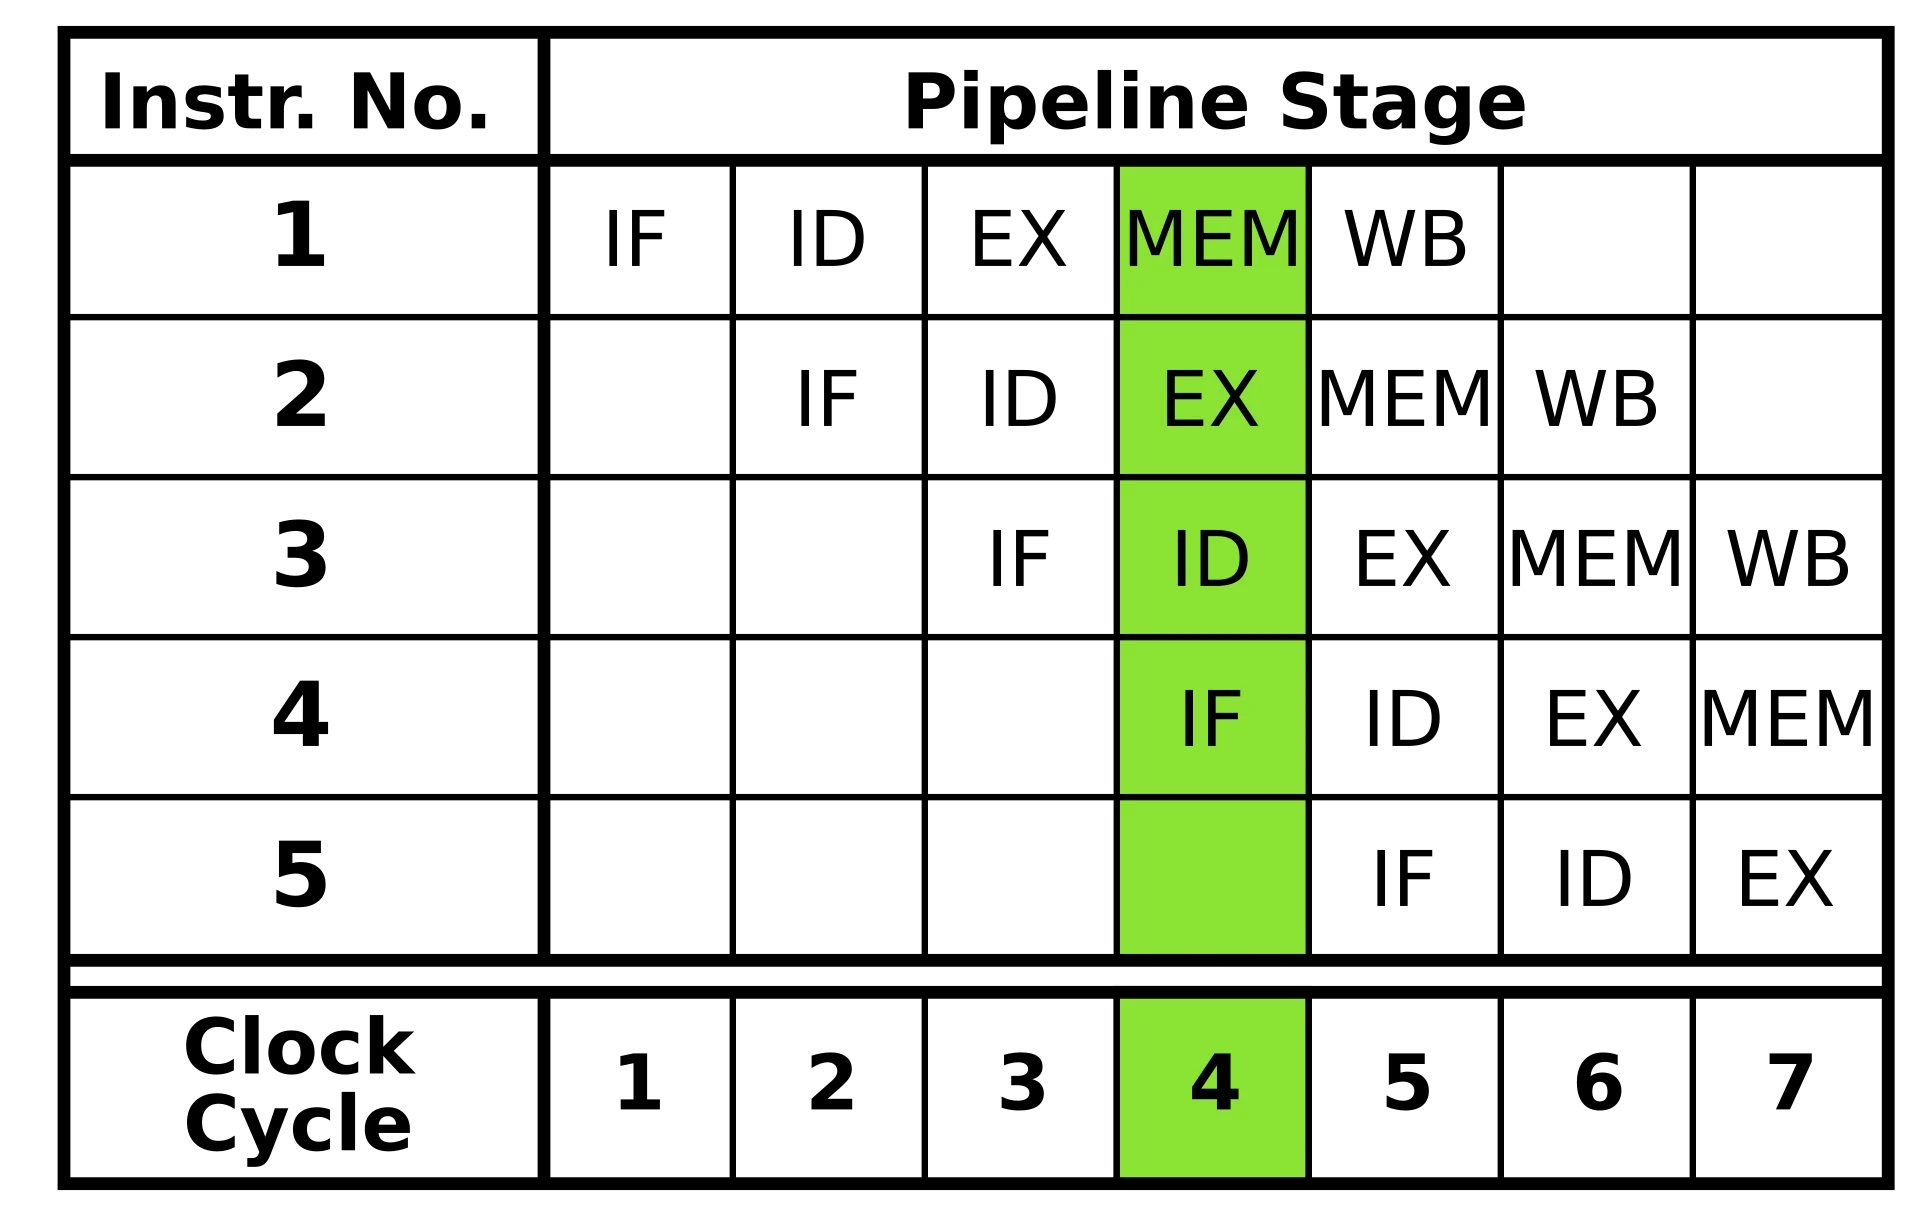
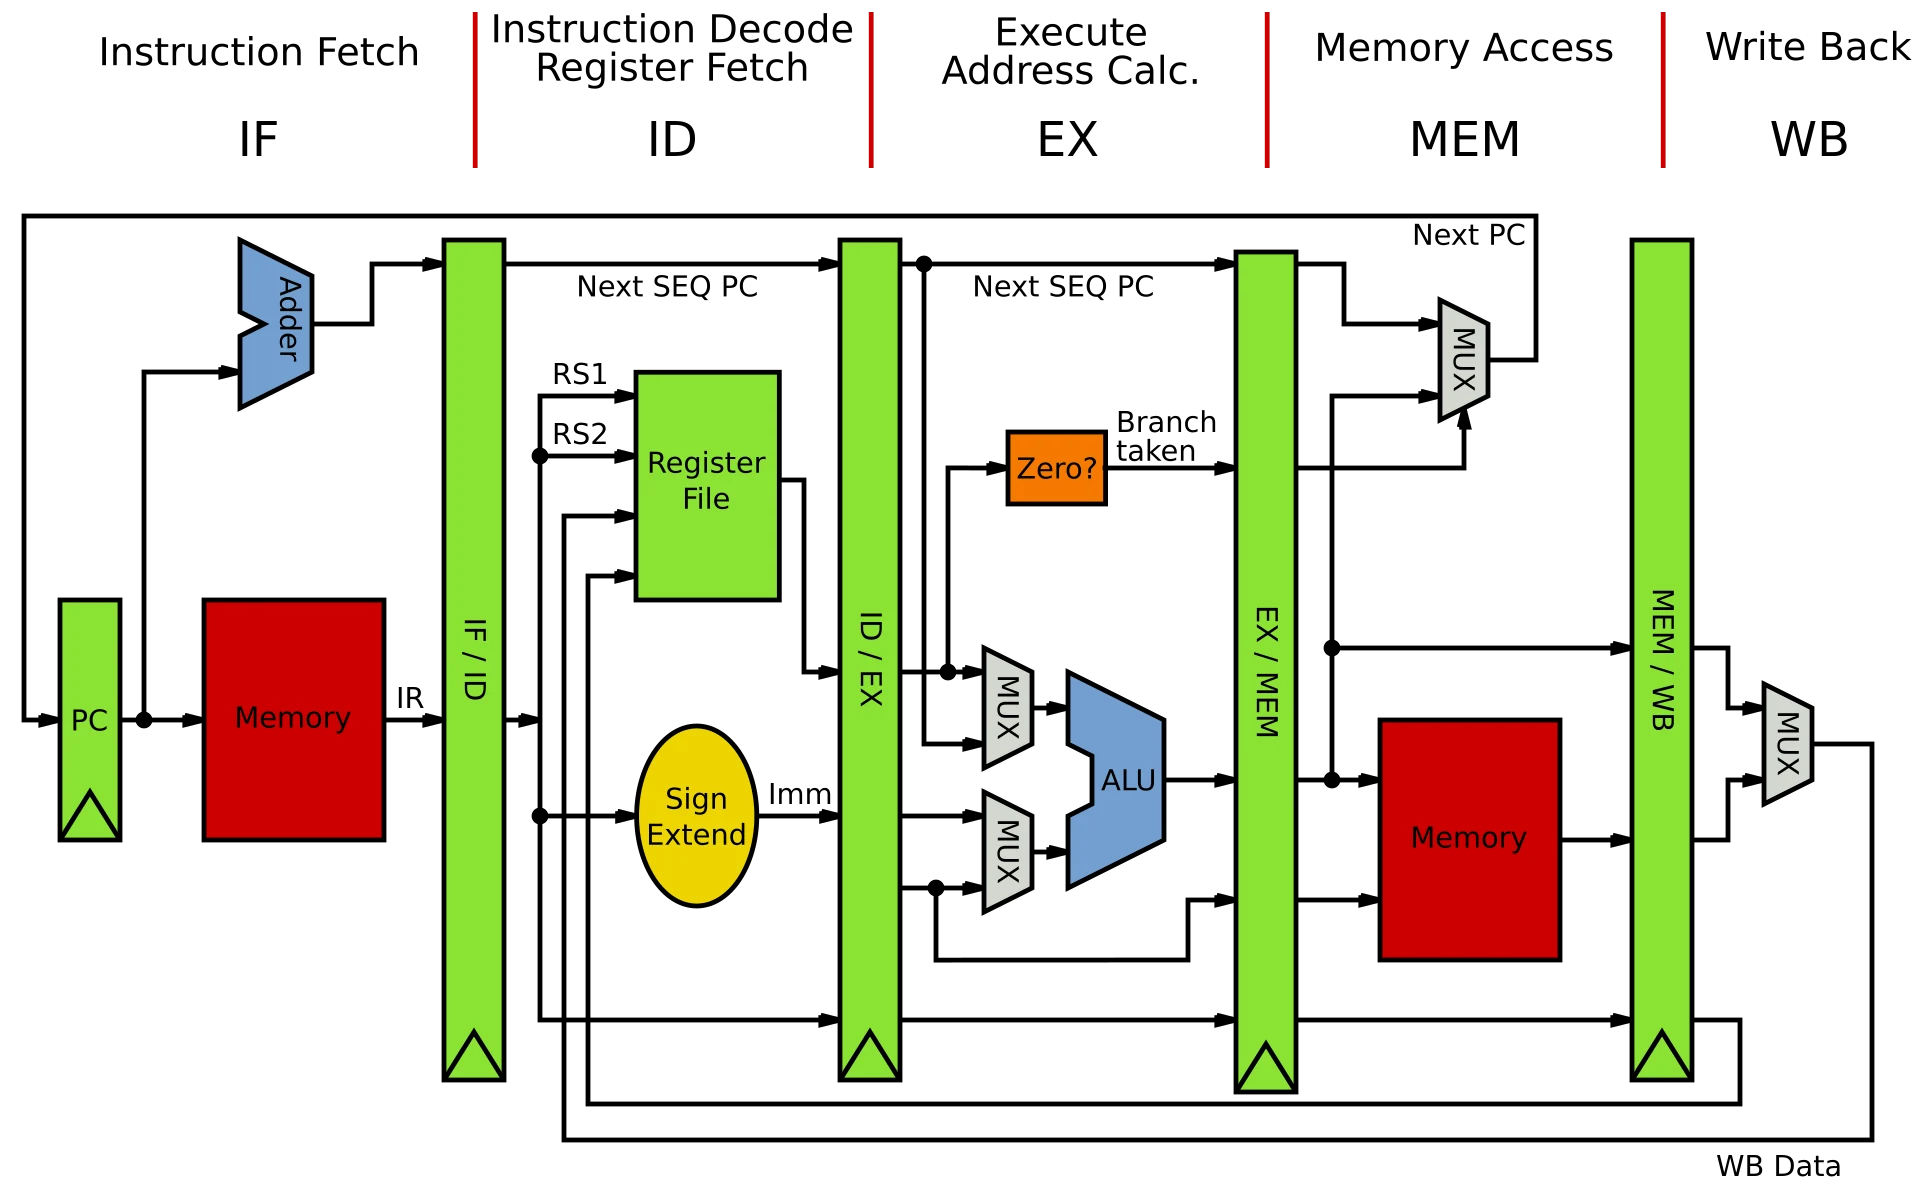
3.7.2 性能计算
设流水线级数 k、指令条数 n、时钟周期为 T:
- 执行时间:
(k + n − 1) × T(理想情况); - 吞吐率:
TP = n / 总时间,理想最大吞吐率 =1 / T; - 加速比:
S = n·k / (k + n − 1),当 n 远大于 k 时趋近于 k; - 效率:
E = S / k。
例:5 级流水线执行 100 条指令,理想加速比 =
100×5 / (5 + 100 − 1) = 500/104 ≈ 4.81。
3.7.3 三类冒险与解决
| 冒险 | 成因 | 典型解决办法 |
|---|---|---|
| 结构冒险 | 多条指令争用同一硬件资源(如同时访存) | 增加资源、指令 Cache 与数据 Cache 分离 |
| 数据冒险 | 后一条指令要用前一条的结果,尚未写回 | 转发(旁路)、插入停顿(气泡)、编译器调度 |
| 控制冒险 | 转移指令改变了取指地址 | 分支预测、延迟槽、提前判断 |
3.7.4 提升性能的其它技术
- 超标量:一个时钟周期发射多条指令(多条并行流水线);
- 超流水:把流水级分得更细(如 8~12 级),主频更高;
- 超长指令字 VLIW:由编译器把多个可并行操作打包成一条长指令;
- SIMD:单指令多数据,适合多媒体与科学计算;
- 多核 / 多线程:在多处理器层面提升并行度。
3.8 典型题
题 1(扩展操作码):指令字长 16 位,地址码 4 位,三地址指令 15 条。二地址指令最多多少条?若二地址用满,一地址指令最多多少条?
解:操作码高 4 位共 16 个编码,三地址占 15 个,剩 1 个可扩展。二地址操作码 = 1 × 2⁴ = 16 条;若二地址用满 16 条,则再没有编码可扩展,一地址指令为 0 条。
题 2(寻址计算):相对寻址指令存放在地址 2500H,指令长 2 字节,地址码字段 A = 06H。求有效地址。
解:相对寻址以取指后的 PC 为基准。取指后 PC = 2500H + 2 = 2502H,EA = 2502H + 06H = 2508H。
题 3(流水线):某流水线共 4 级,各级耗时分别为 10 ns、8 ns、12 ns、9 ns。求流水线时钟周期与执行 50 条指令的总时间。
解:时钟周期取最长级 = 12 ns;总时间 = (4 + 50 − 1) × 12 = 53 × 12 = 636 ns。若不能流水,则总时间 = 50 × (10+8+12+9) = 1950 ns,加速比约 3.07。
题 4:简述"数据冒险"的一种判断方法,并说明"转发"为什么能减少停顿。
解:比较后续指令的源寄存器与前面指令的目的寄存器,若相同且前面指令尚未写回,则存在数据冒险。转发把 ALU 的计算结果在写回前直接从流水寄存器旁路到 EX 级输入端,使后续指令不必等到 WB 才拿到数据,从而把停顿从 23 拍减少到 01 拍。
更多练习:见附录 C 自测清单。
4. 第 4 章 存储子系统(重点章)
本章回答"数据放在哪里、怎样既快又大又便宜"。主线:分层的存储体系 → 半导体存储器 → 主存怎么搭起来 → 磁盘与 RAID → Cache → 虚拟存储器。
4.1 存储系统概述
4.1.1 层次结构
理想的存储器应当"速度快、容量大、价格低",三者不可兼得,于是采用分层:上层快而小、下层慢而大,用程序访问的局部性把常用信息上调到高速层,从而获得接近"全快"的性能。
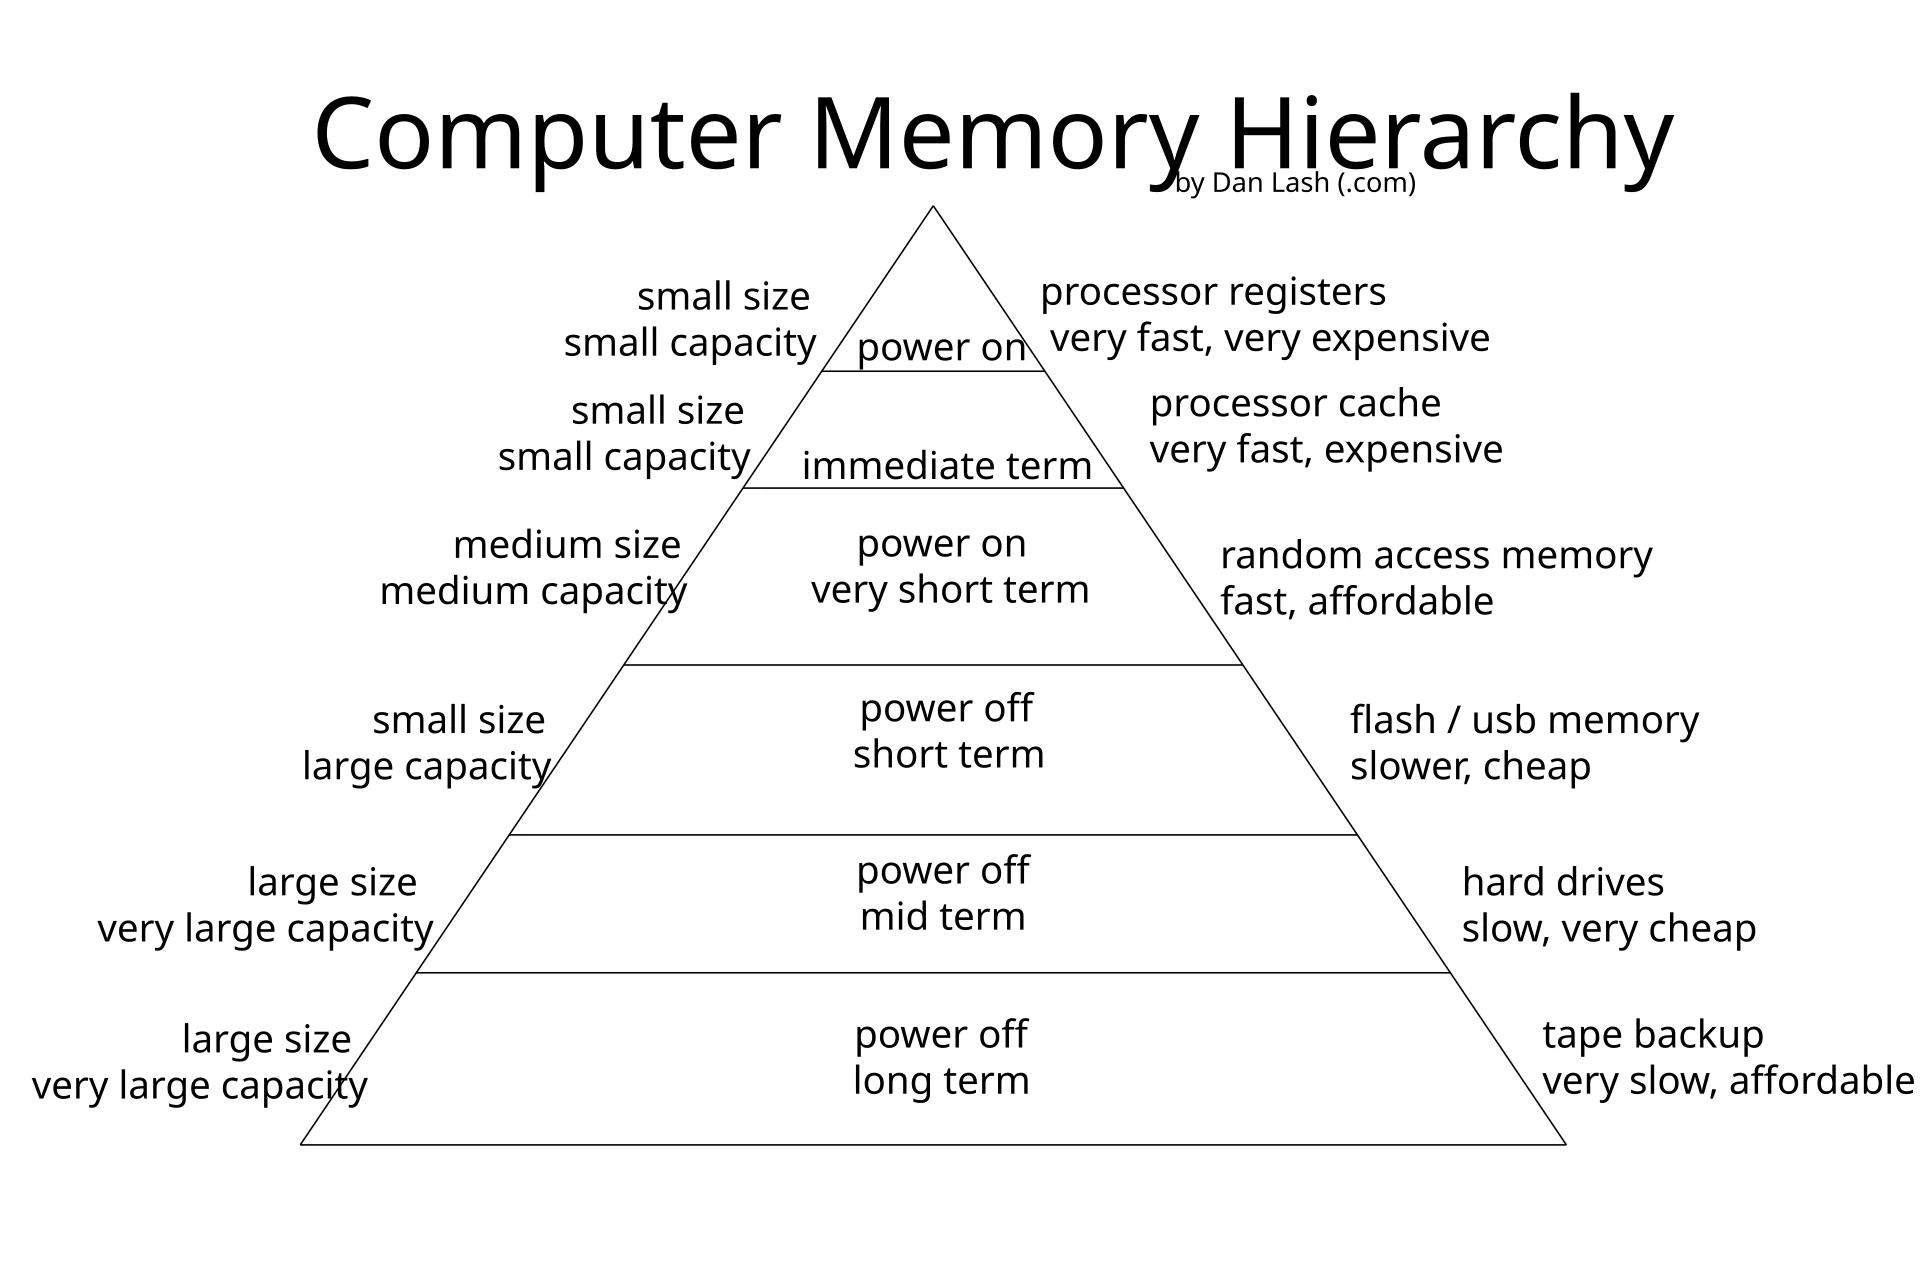
局部性原理分两种:
- 时间局部性:刚被访问过的数据很可能马上再被访问(循环、重复调用);
- 空间局部性:被访问单元的邻近单元很可能马上被访问(数组、顺序代码)。
局部性是 Cache 与虚拟存储器能起作用的前提,也是本章的"总开关"。
4.1.2 存储器的分类
| 分类角度 | 类型 | 说明 |
|---|---|---|
| 存取方式 | 随机存取(RAM) | 存取时间与地址无关 |
| 顺序存取(磁带) | 必须按顺序找 | |
| 直接存取(磁盘) | 先找道再顺序找扇区 | |
| 易失性 | 易失(RAM) | 断电即丢 |
| 非易失(ROM、Flash、磁盘) | 断电保留 | |
| 读写性 | 只读(ROM) | 运行时只能读 |
| 读写(RAM) | 运行时可读可写 |
4.1.3 主要技术指标
- 存储容量:芯片常以"字数 × 位数"标注,如
8K × 8; - 存取时间 Ta:从发出访问请求到数据可用;
- 存储周期 Tm:两次独立访问之间必须的最小间隔(
Tm ≥ Ta,因为读后需要恢复); - 存储带宽:单位时间可读写的数据量。
4.2 半导体存储原理与芯片
4.2.1 SRAM 与 DRAM
| 对比项 | SRAM(静态) | DRAM(动态) |
|---|---|---|
| 存储单元 | 触发器(6 个晶体管) | 电容(1 个晶体管 + 1 个电容) |
| 是否需要刷新 | 不需要 | 需要定期刷新 |
| 速度 | 快 | 慢 |
| 集成度 | 低 | 高 |
| 位成本 | 高 | 低 |
| 功耗 | 较大(静态保持) | 小 |
| 用途 | Cache | 主存 |
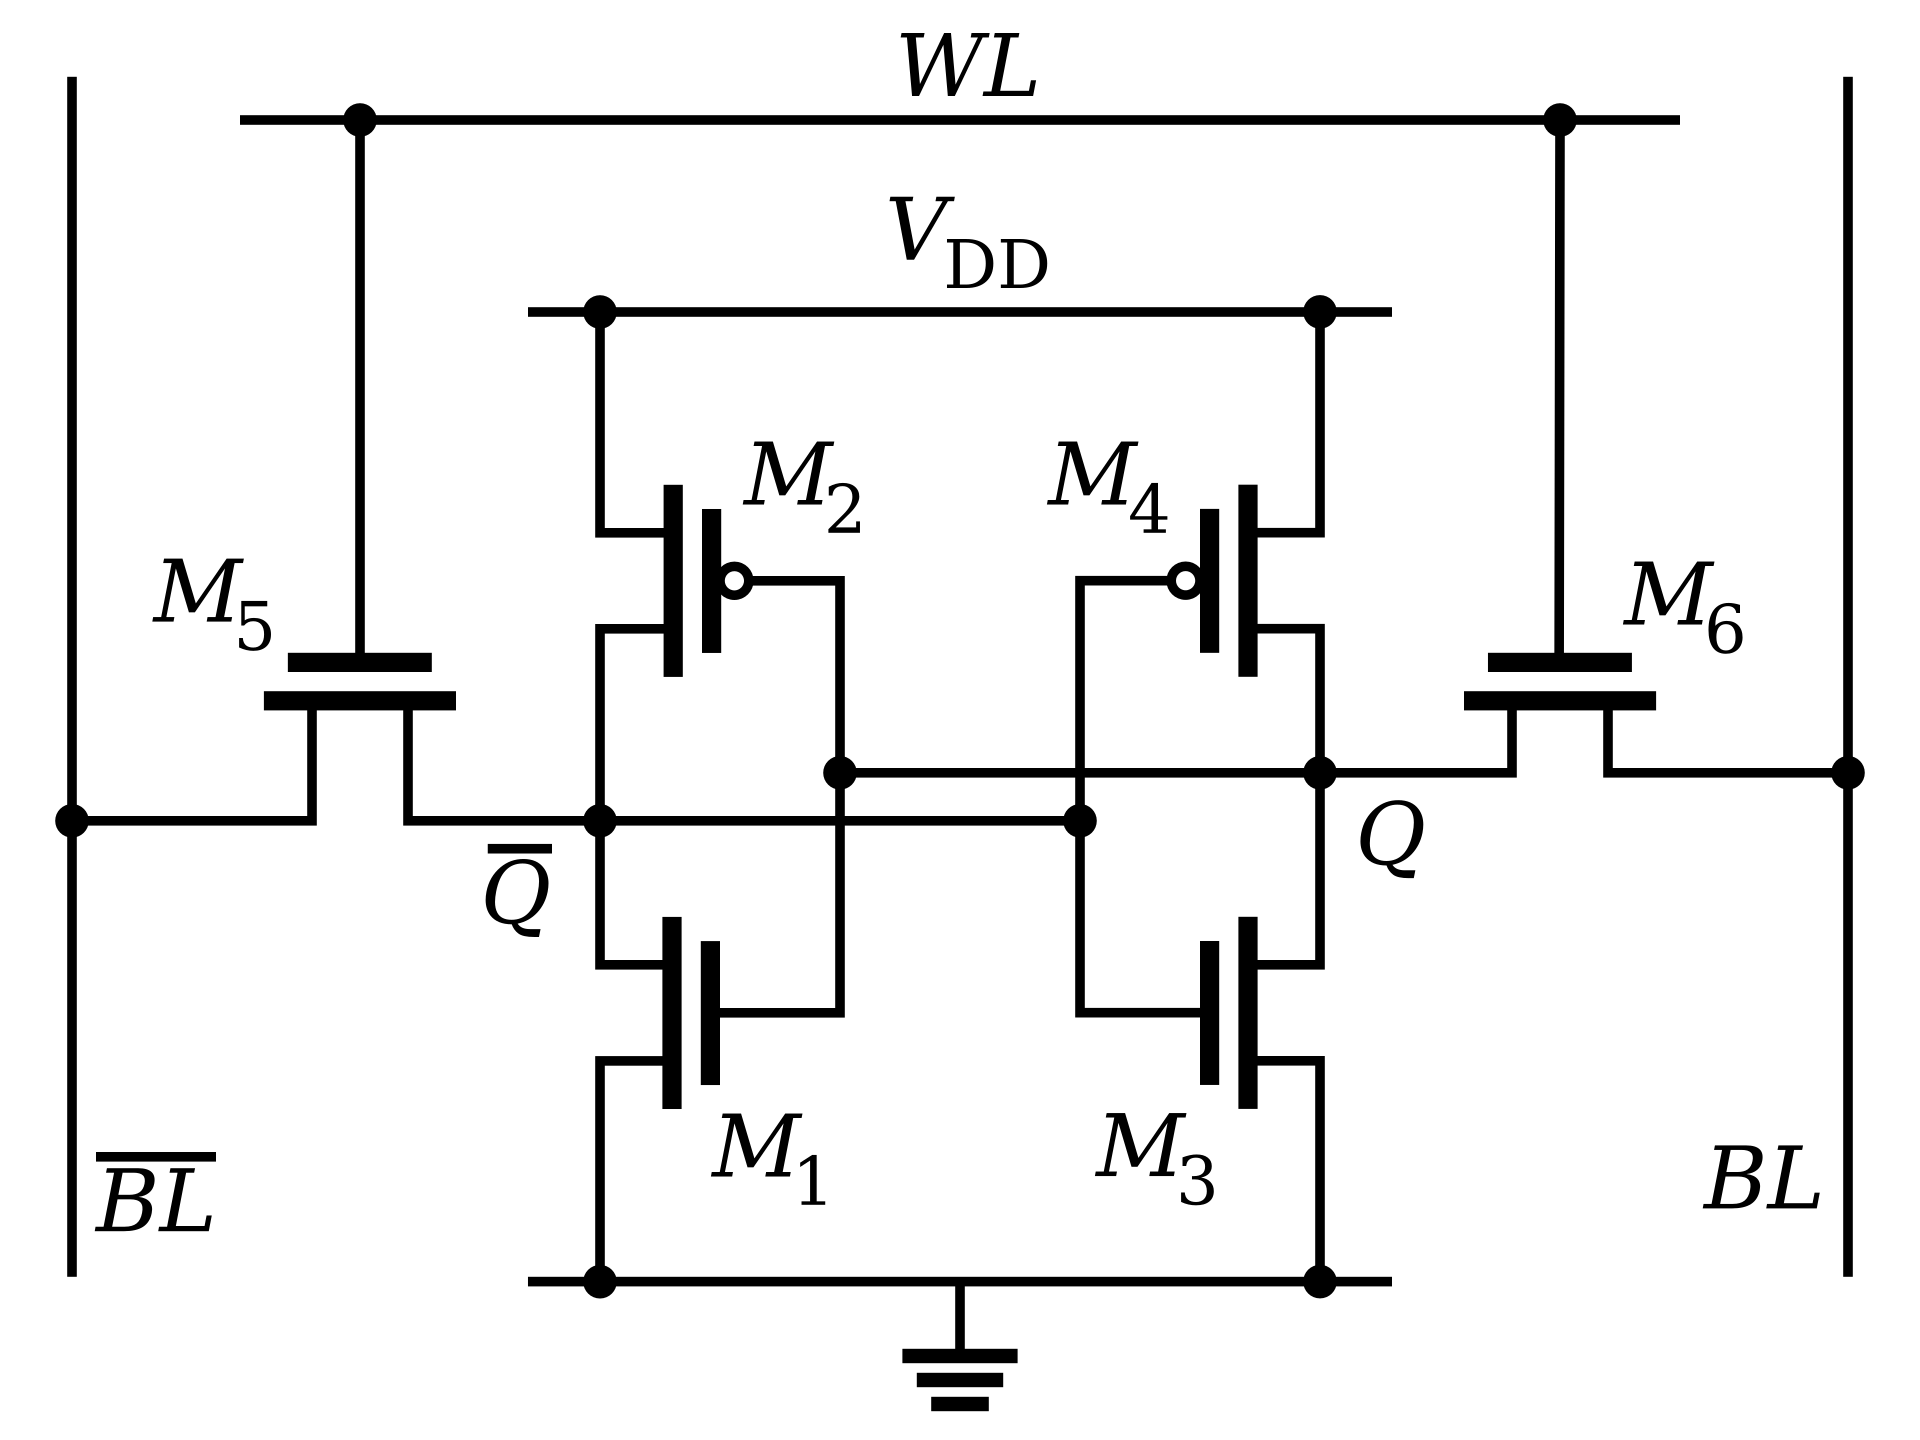
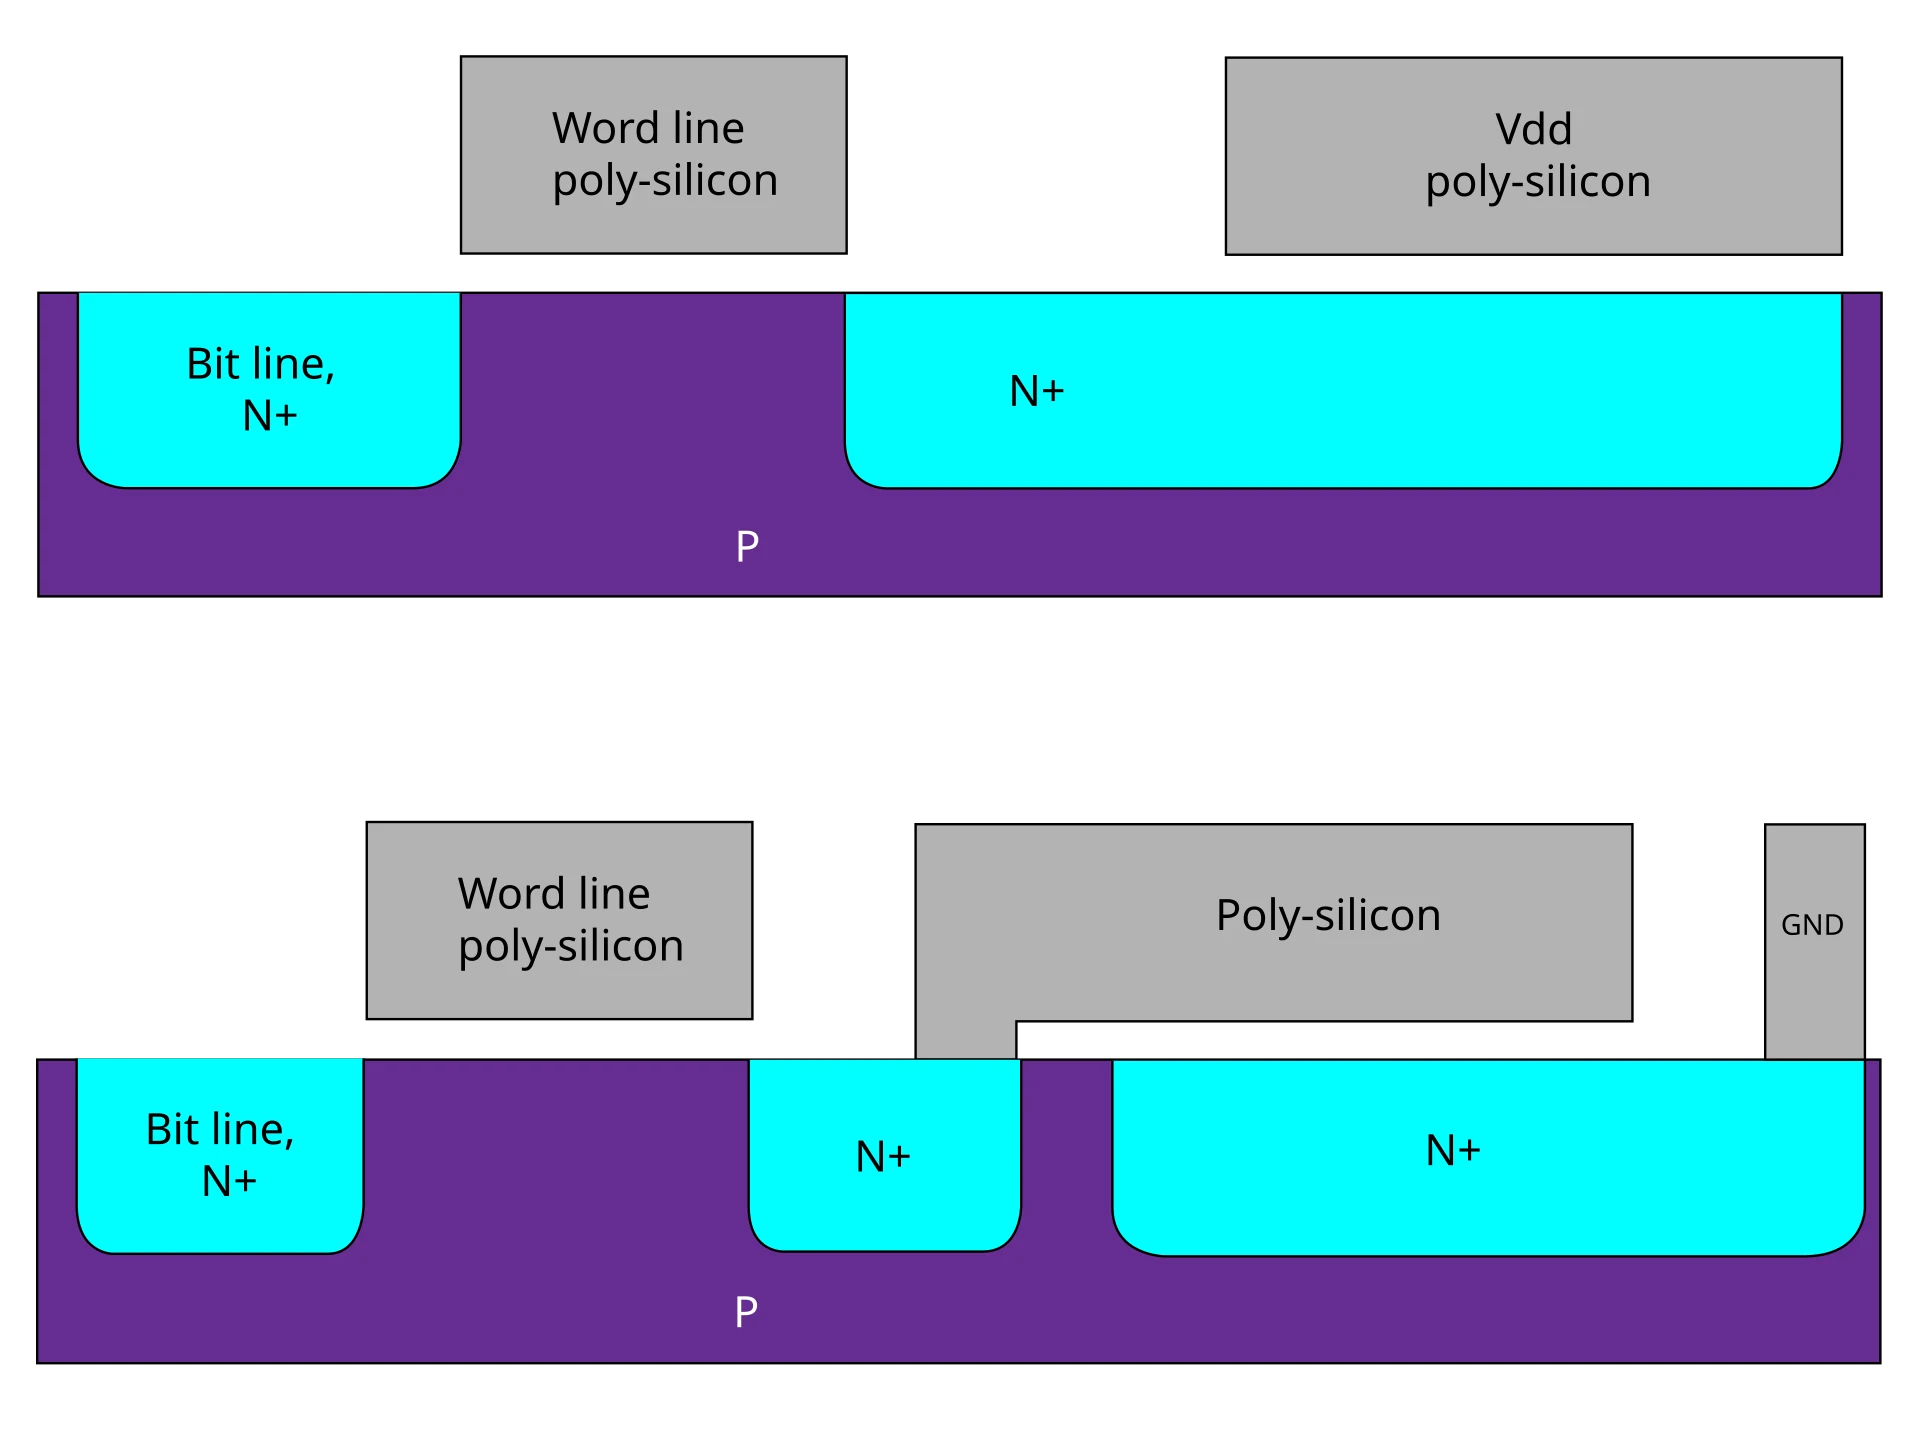
DRAM 用电容存储电荷,电荷会泄漏,所以必须定时刷新(读出后重新写入)。刷新按"行"进行,三种方式:
| 刷新方式 | 做法 | 特点 |
|---|---|---|
| 集中刷新 | 在刷新周期末集中刷新所有行 | 有很长的"死时间" |
| 分散刷新 | 每个存取周期后都刷新一行 | 无长死区,但系统速度变慢 |
| 异步刷新 | 把刷新均匀分散到刷新周期内 | 折中,实际最常用 |
例:DRAM 共 128 行,存取周期 0.5 μs,刷新间隔 2 ms。集中刷新时 =
128 × 0.5 = 64 μs的死时间,死时间率 =64/2000 = 3.2%。
DRAM 还采用地址复用:行地址与列地址分两次送(用 RAS、CAS 信号),引脚数减半,这也是 DRAM 比 SRAM 慢的原因之一。
4.2.2 只读存储器与 Flash
| 类型 | 写入方式 | 擦除 |
|---|---|---|
| MROM(掩膜 ROM) | 出厂时由掩膜决定 | 不可 |
| PROM | 用户一次性编程(熔丝) | 不可 |
| EPROM | 紫外线照射擦除 | 可(整片) |
| EEPROM | 电擦除,可按字节改写 | 可 |
| Flash(闪存) | 电擦除,按块操作、非易失 | 可(按块) |
Flash 是 U 盘、SSD、BIOS 的主流介质:非易失、可电擦写、按块擦除,写之前必须先擦除整块。
4.3 半导体存储器的组织逻辑(主存设计)
单片芯片容量不够,就用多片组合:位扩展加宽数据、字扩展增加单元数。
- 位扩展:各芯片地址线与片选并联,数据线分别接数据总线的不同位。如 8 片
8K×1拼成8K×8。 - 字扩展:各芯片数据线共用,高位地址经译码器产生片选信号,选择哪一片工作。如 4 片
8K×8拼成32K×8。 - 字位同时扩展:先位扩展成小组,再字扩展成多组。
例:用
8K × 8的芯片构成32K × 16的主存。 片数 =(32K / 8K) × (16 / 8) = 4 × 2 = 8片。 地址线:32K 单元需 15 位(A0A14);片内 8K 用 13 位(A0A12);高位 A13、A14 接 2-4 译码器产生 4 个片选,每个片选同时选通"位扩展"的两片。数据线:两组各 8 位拼成 16 位。
4.4 磁存储原理与磁盘
4.4.1 磁盘结构与容量
磁盘按"盘面—磁道—扇区"组织:同一半径上所有盘面的磁道构成一个柱面。
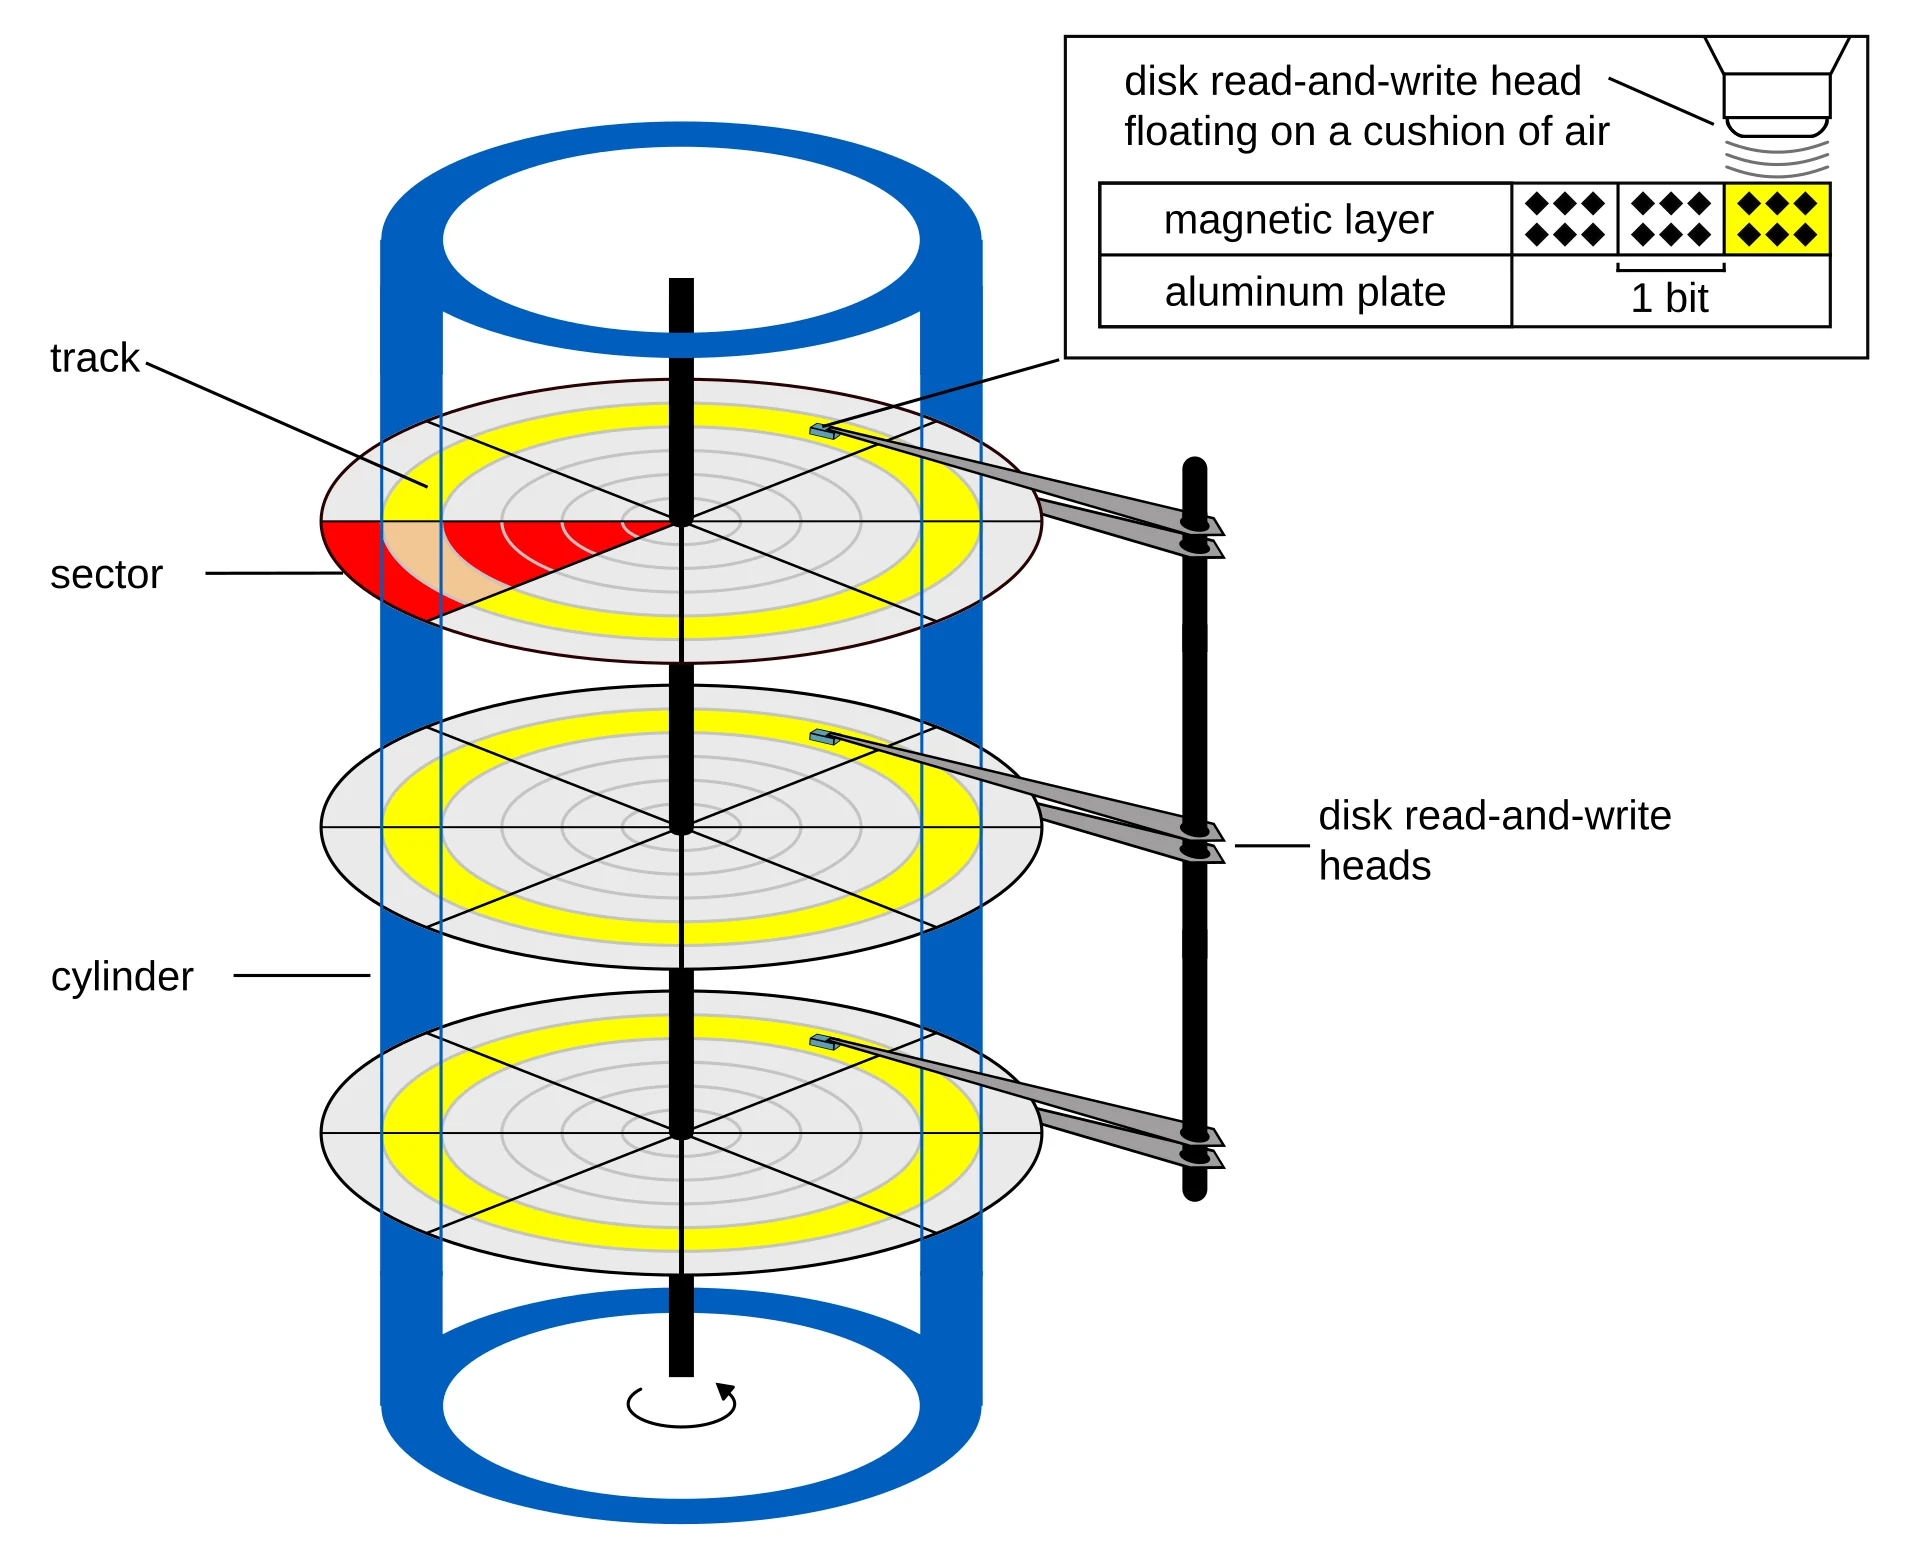
- 容量:
总容量 = 盘面数 × 每面磁道数 × 每道扇区数 × 每扇区字节数; - 存取时间:
Ta = 寻道时间 + 旋转等待时间 + 数据传输时间; - 平均旋转等待时间 = 转半圈的时间 =
1 / (2r)(r 为转速,单位 r/s)。
例:转速 7200 r/min = 120 r/s,则一圈 8.33 ms,平均旋转等待 ≈ 4.17 ms。
4.4.2 RAID
RAID(廉价磁盘冗余阵列)用多块磁盘组合出更高性能/可靠性:
| 级别 | 思想 | 特点 |
|---|---|---|
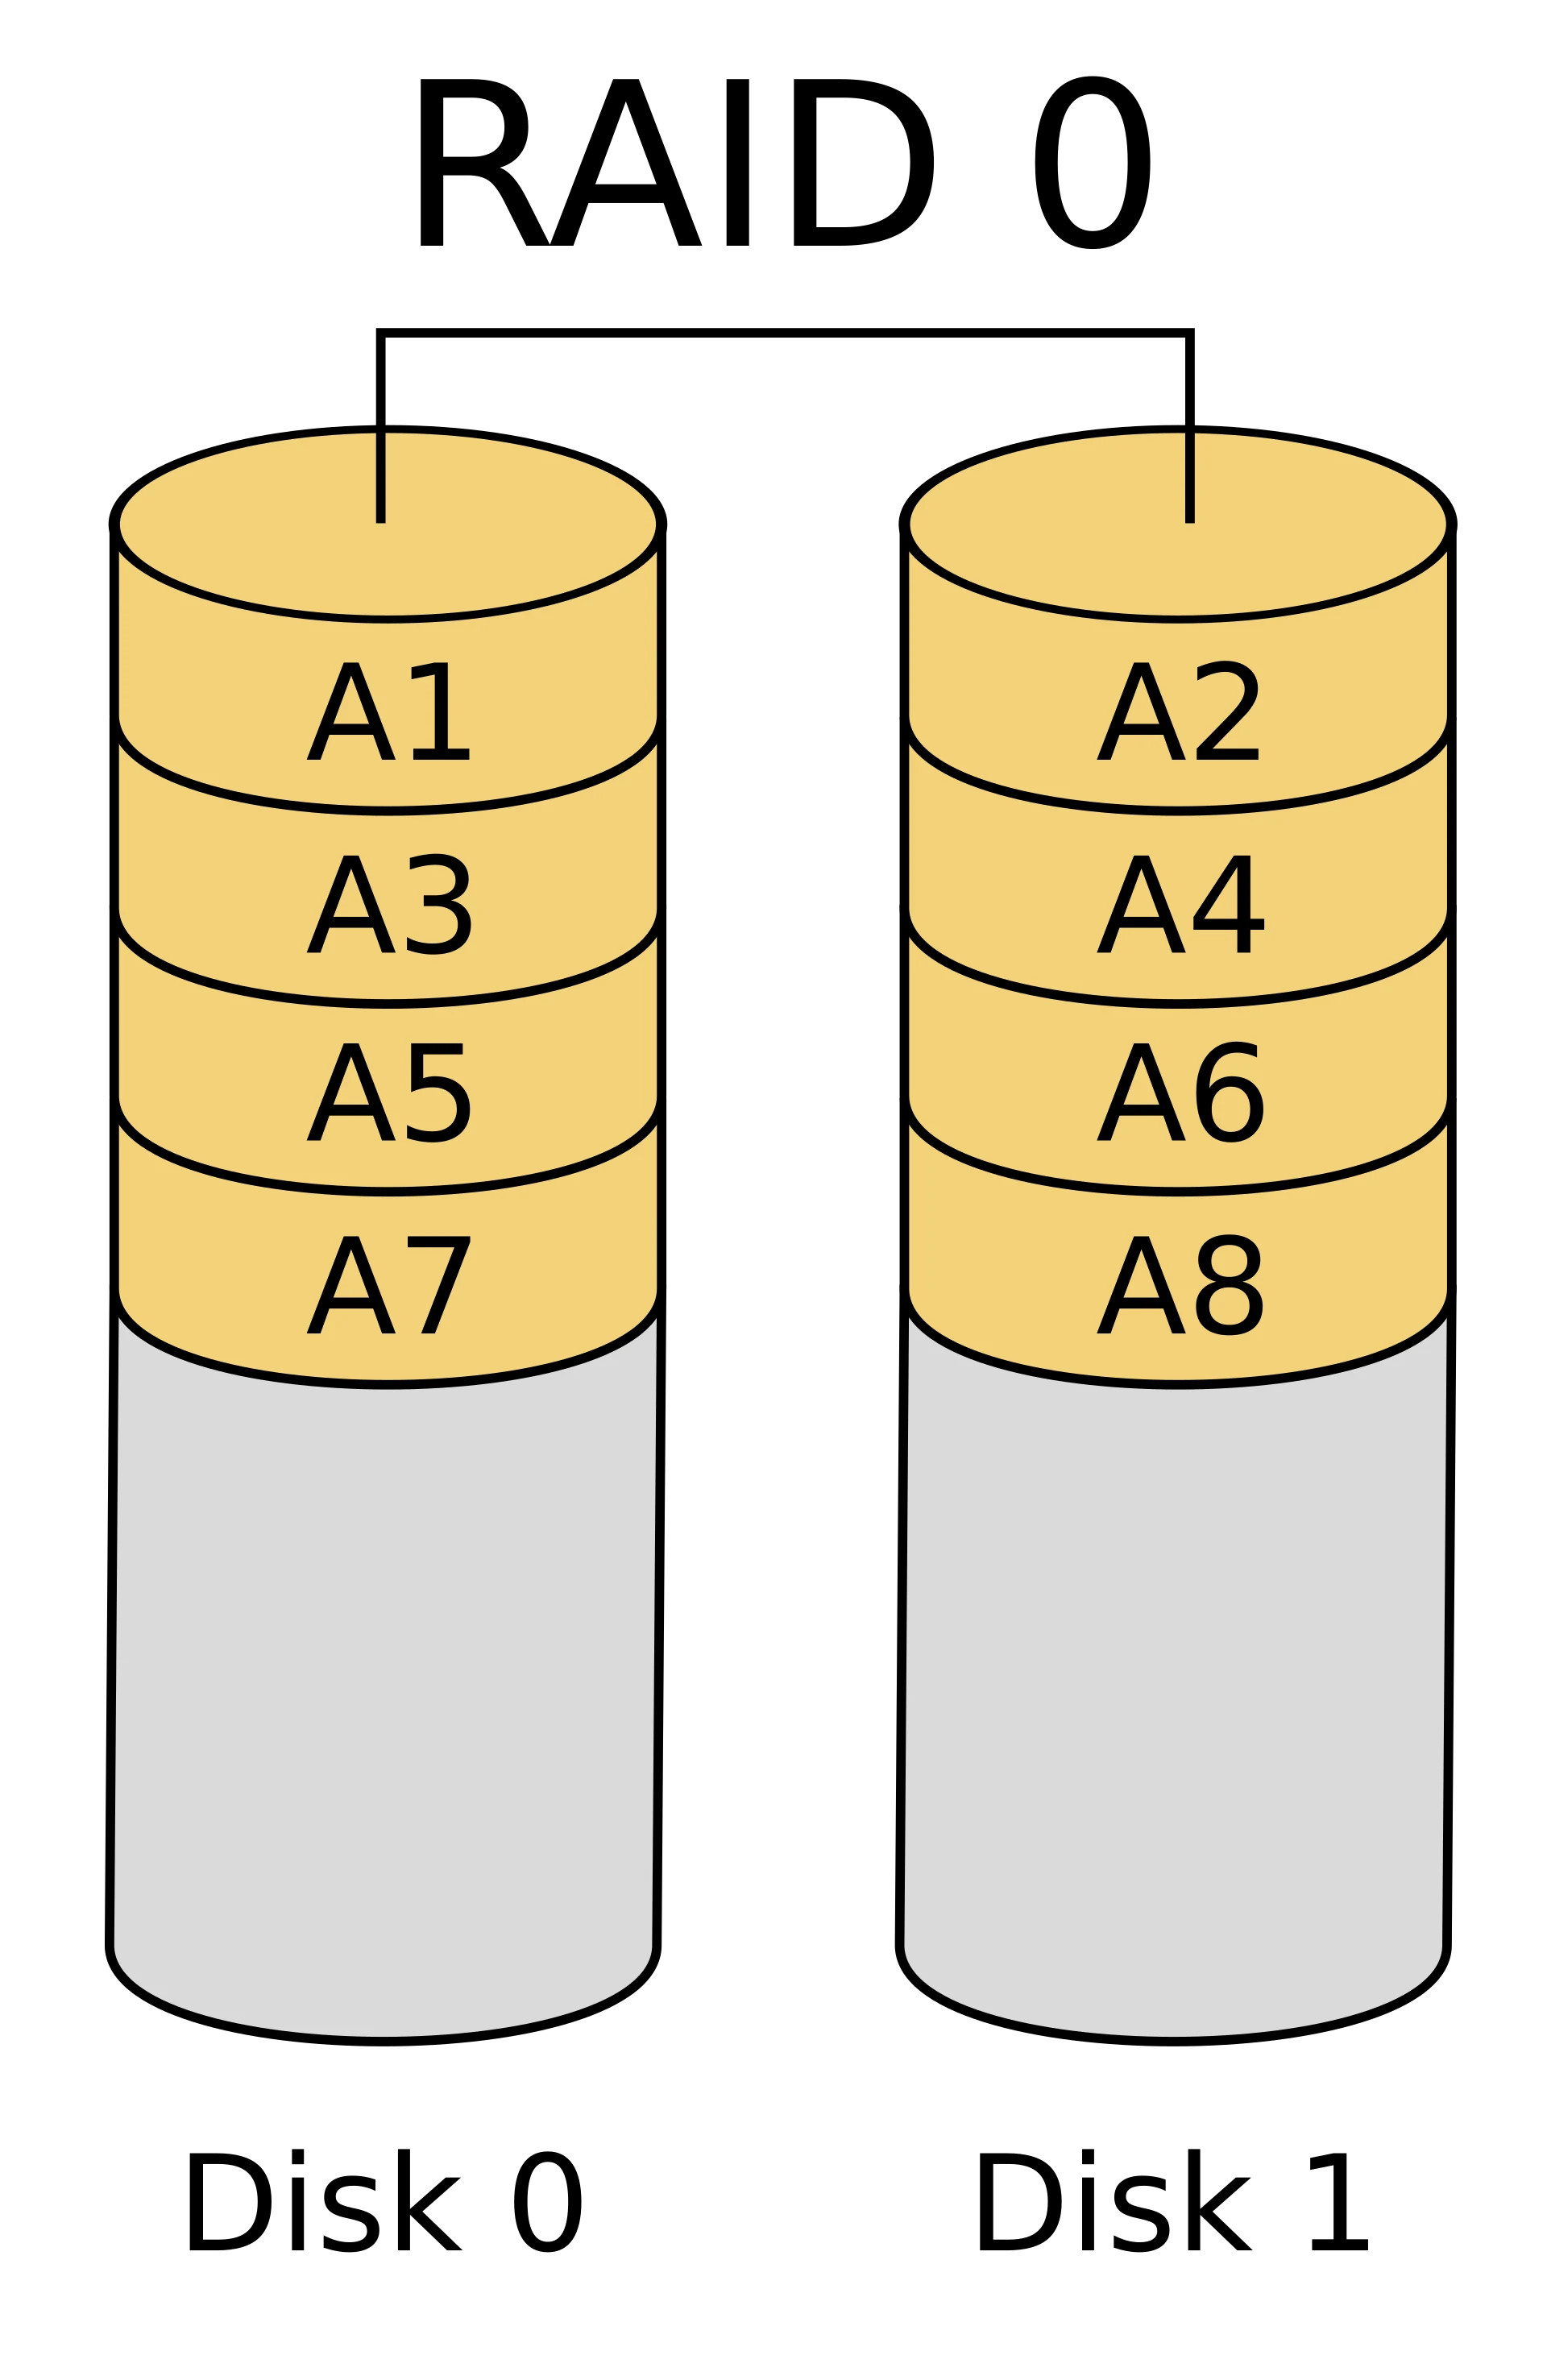
| RAID 0 | 条带(striping) | 容量与速度提升,无冗余,坏一块全丢 |
| RAID 1 | 镜像(mirroring) | 100% 备份,可靠性高,利用率 50% |
| RAID 2/3 | 位/字节交叉 + 校验盘 | 校验盘成瓶颈,已少用 |
| RAID 4 | 块交叉 + 专用校验盘 | 同上 |
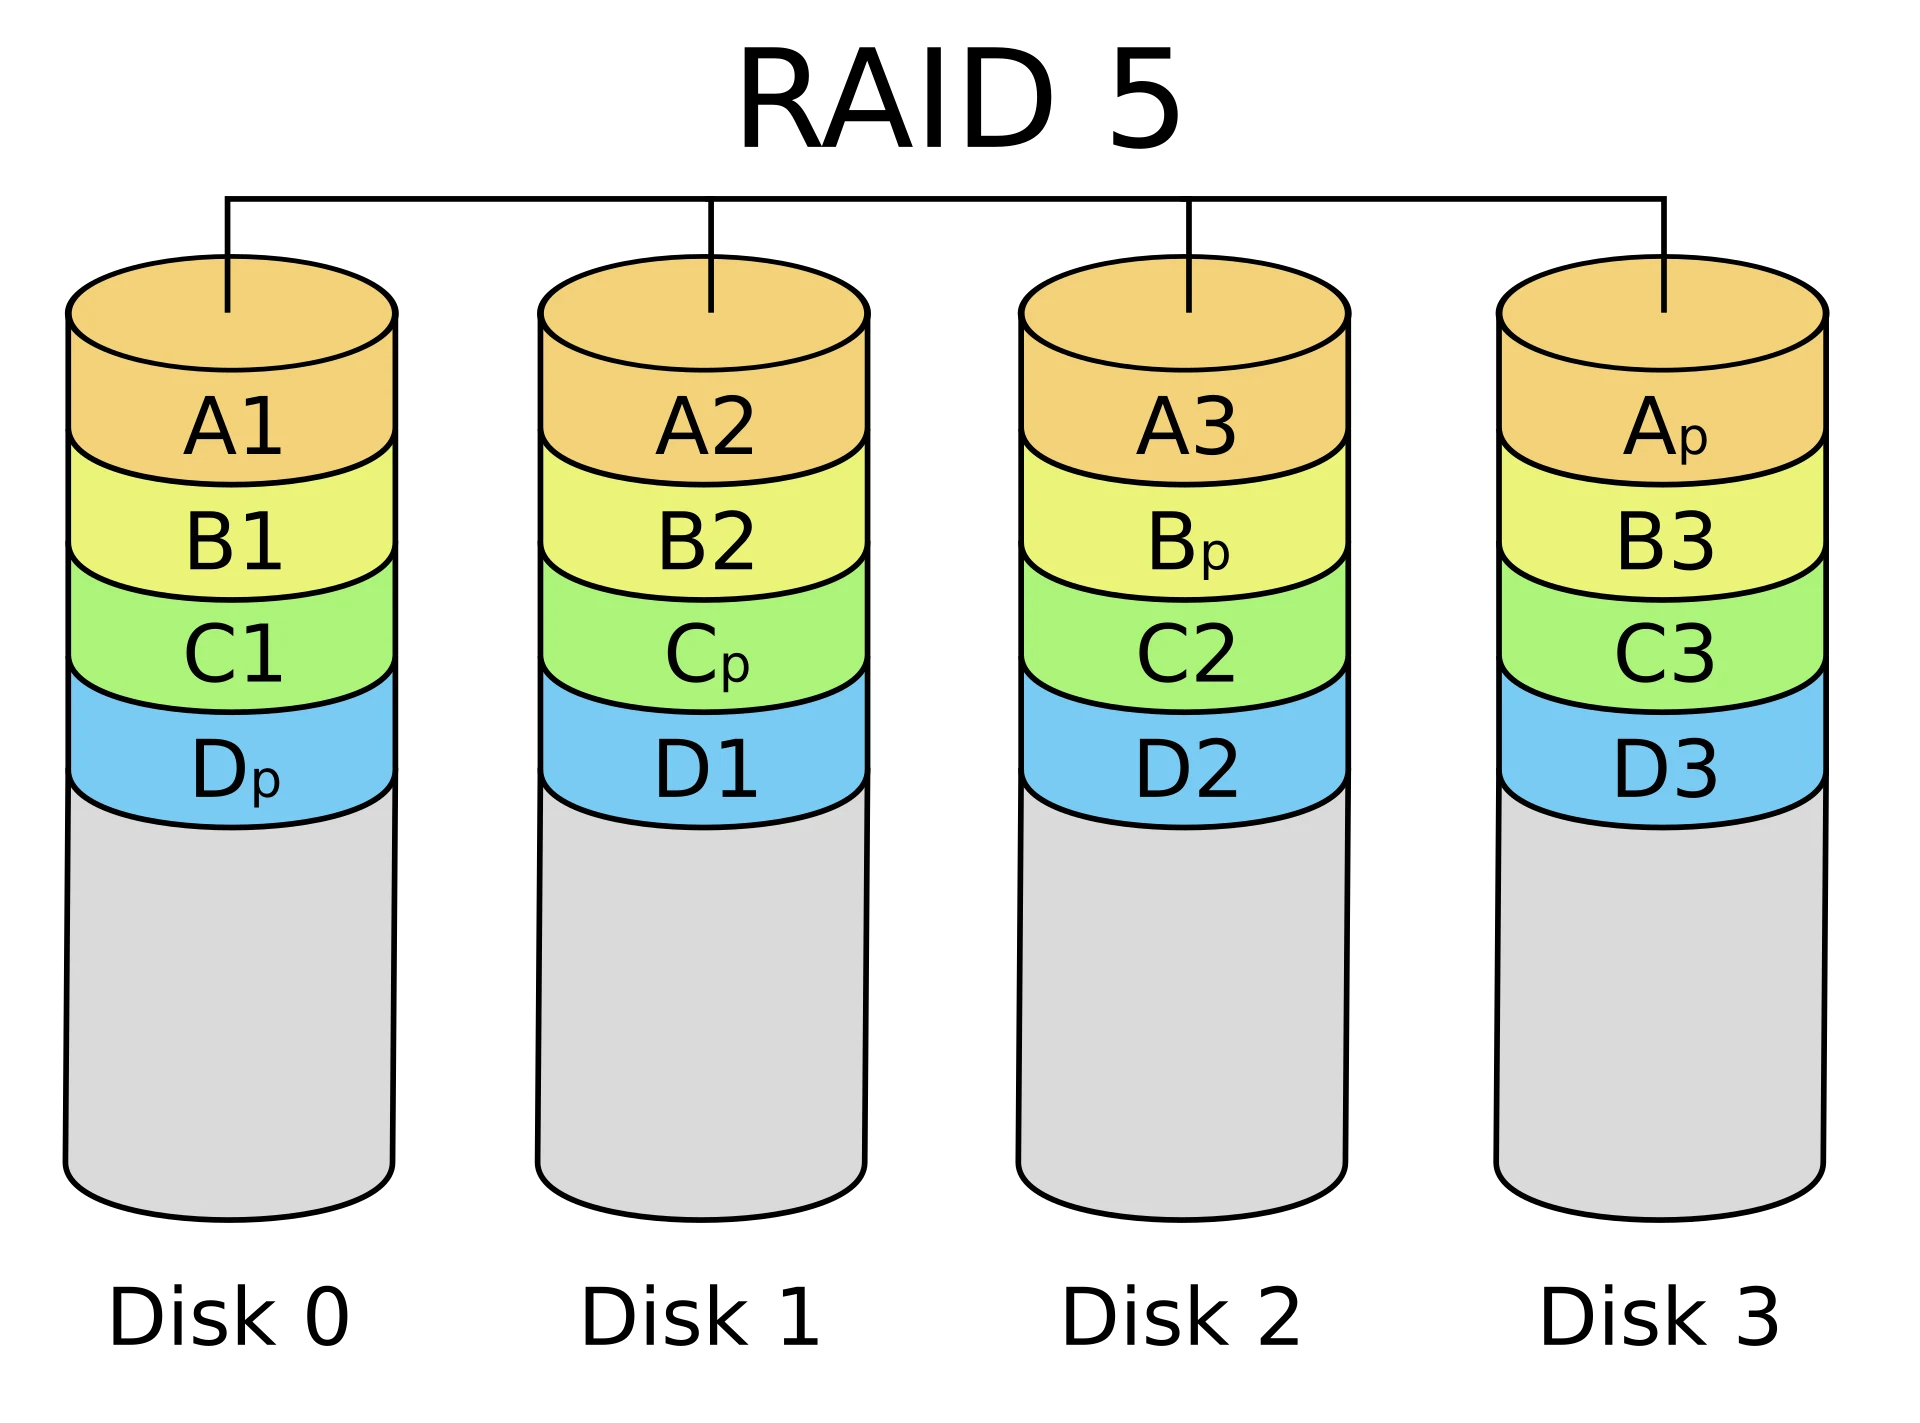
| RAID 5 | 块交叉 + 分布式校验 | 兼顾性能与冗余,最常用 |
4.5 光存储(了解)
CD/DVD/蓝光用激光在介质上读写,容量大、成本低、便于分发,但读写速度与随机访问能力不及磁盘;现代更多作为归档与备份介质。
4.6 高速缓冲存储器 Cache
4.6.1 工作原理
Cache 把主存中近期常用块的副本放到 CPU 附近,使绝大多数访问不必直接等主存。命中时按 Cache 速度,未命中时才访问主存并把整块调入。
性能公式(设命中率 h、Cache 存取时间 Tc、主存存取时间 Tm):
平均访问时间 Ta = h × Tc + (1 − h) × Tm
例:h = 0.95,Tc = 2 ns,Tm = 20 ns,则
Ta = 0.95×2 + 0.05×20 = 2.9 ns;相较不用 Cache 的 20 ns,加速约20 / 2.9 ≈ 6.9倍。可见命中率对性能影响极大。
4.6.2 三种映射方式与地址划分
主存地址字段如何切分,取决于映射方式:
| 映射方式 | 地址字段划分 | 主存块去向 | 比较范围 |
|---|---|---|---|
| 直接映射 | 标记 + 行号 + 块内地址 | 固定行:行号 = 块号 mod 行数 | 只比较 1 个 |
| 全相联 | 标记 + 块内地址 | 任意行 | 比较所有行 |
| 组相联(n 路) | 标记 + 组号 + 块内地址 | 固定组内任意行 | 比较组内 n 行 |
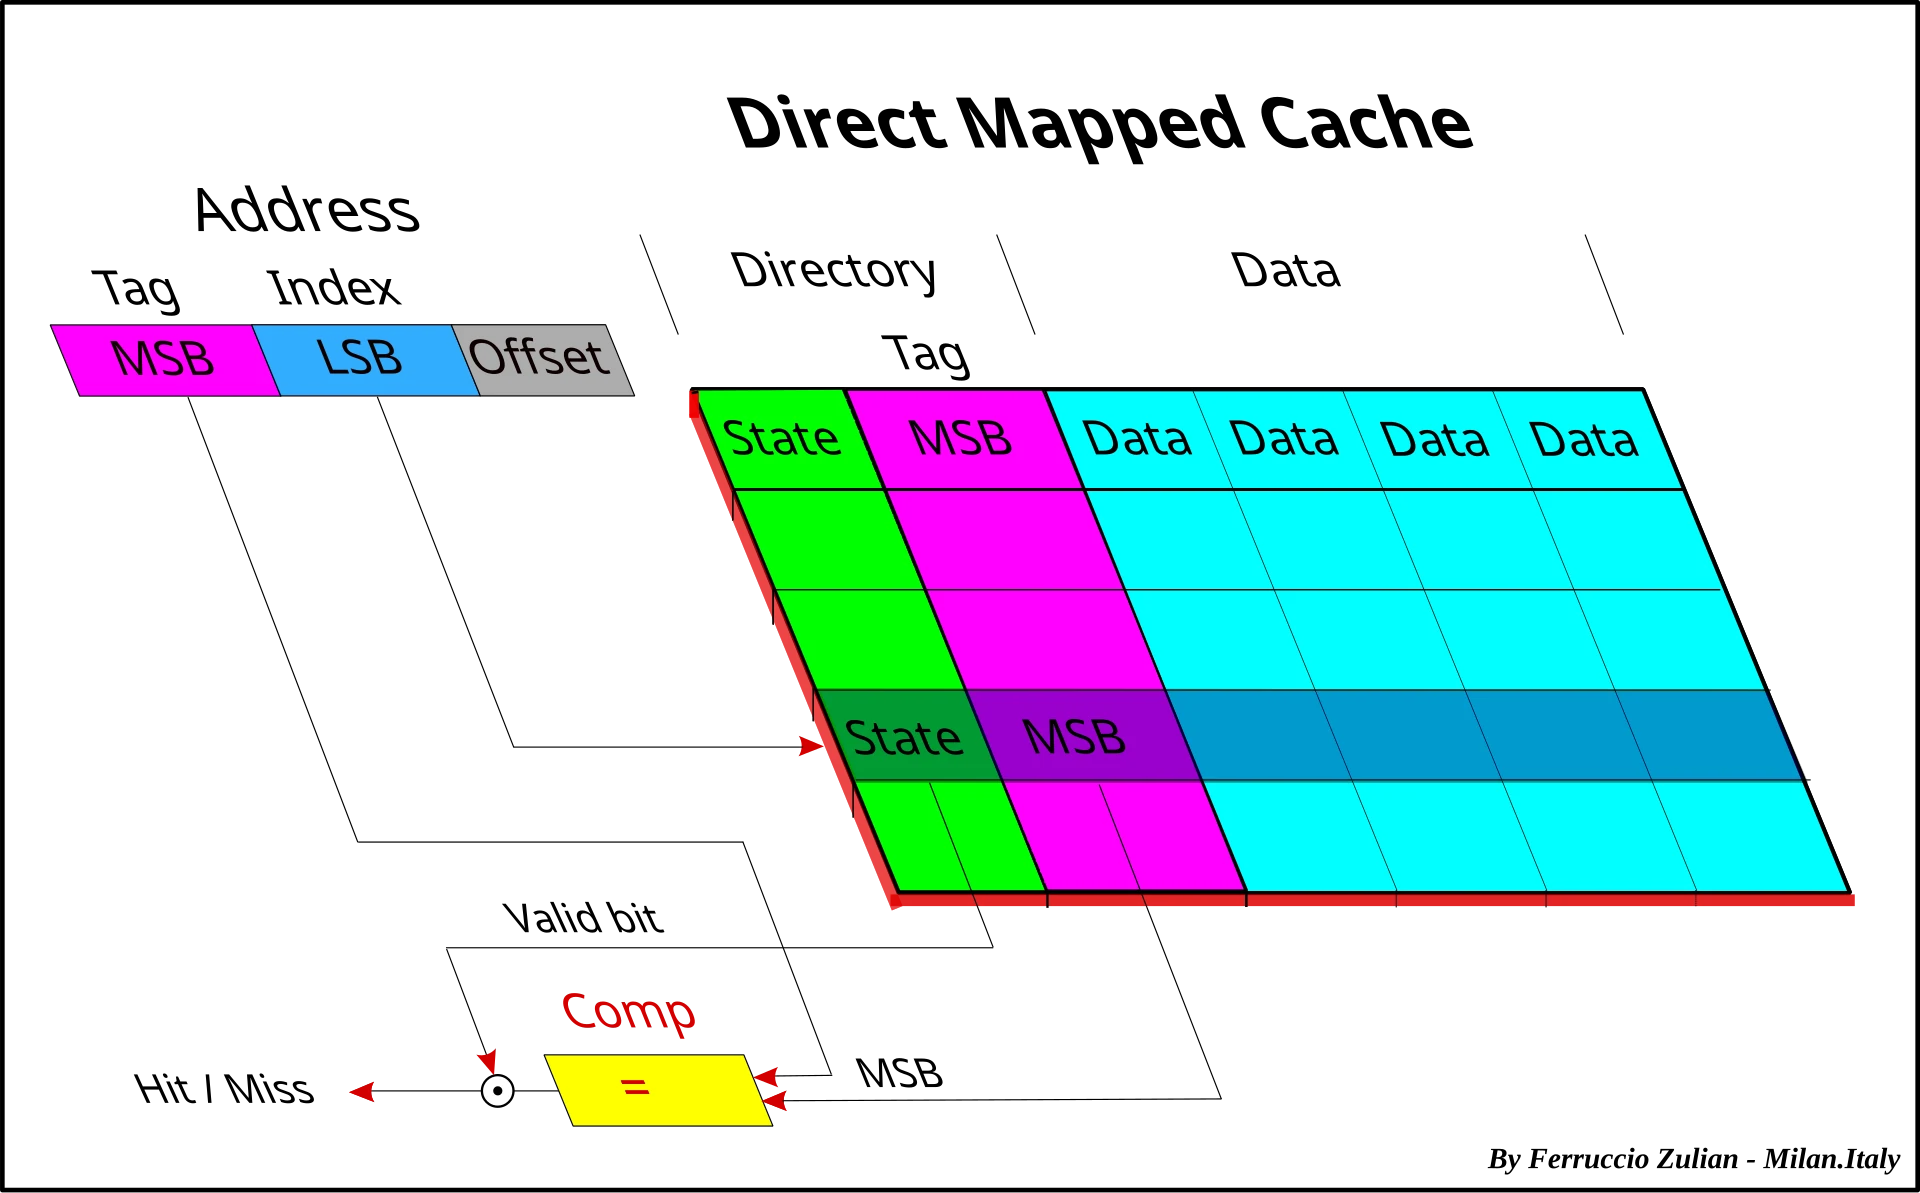
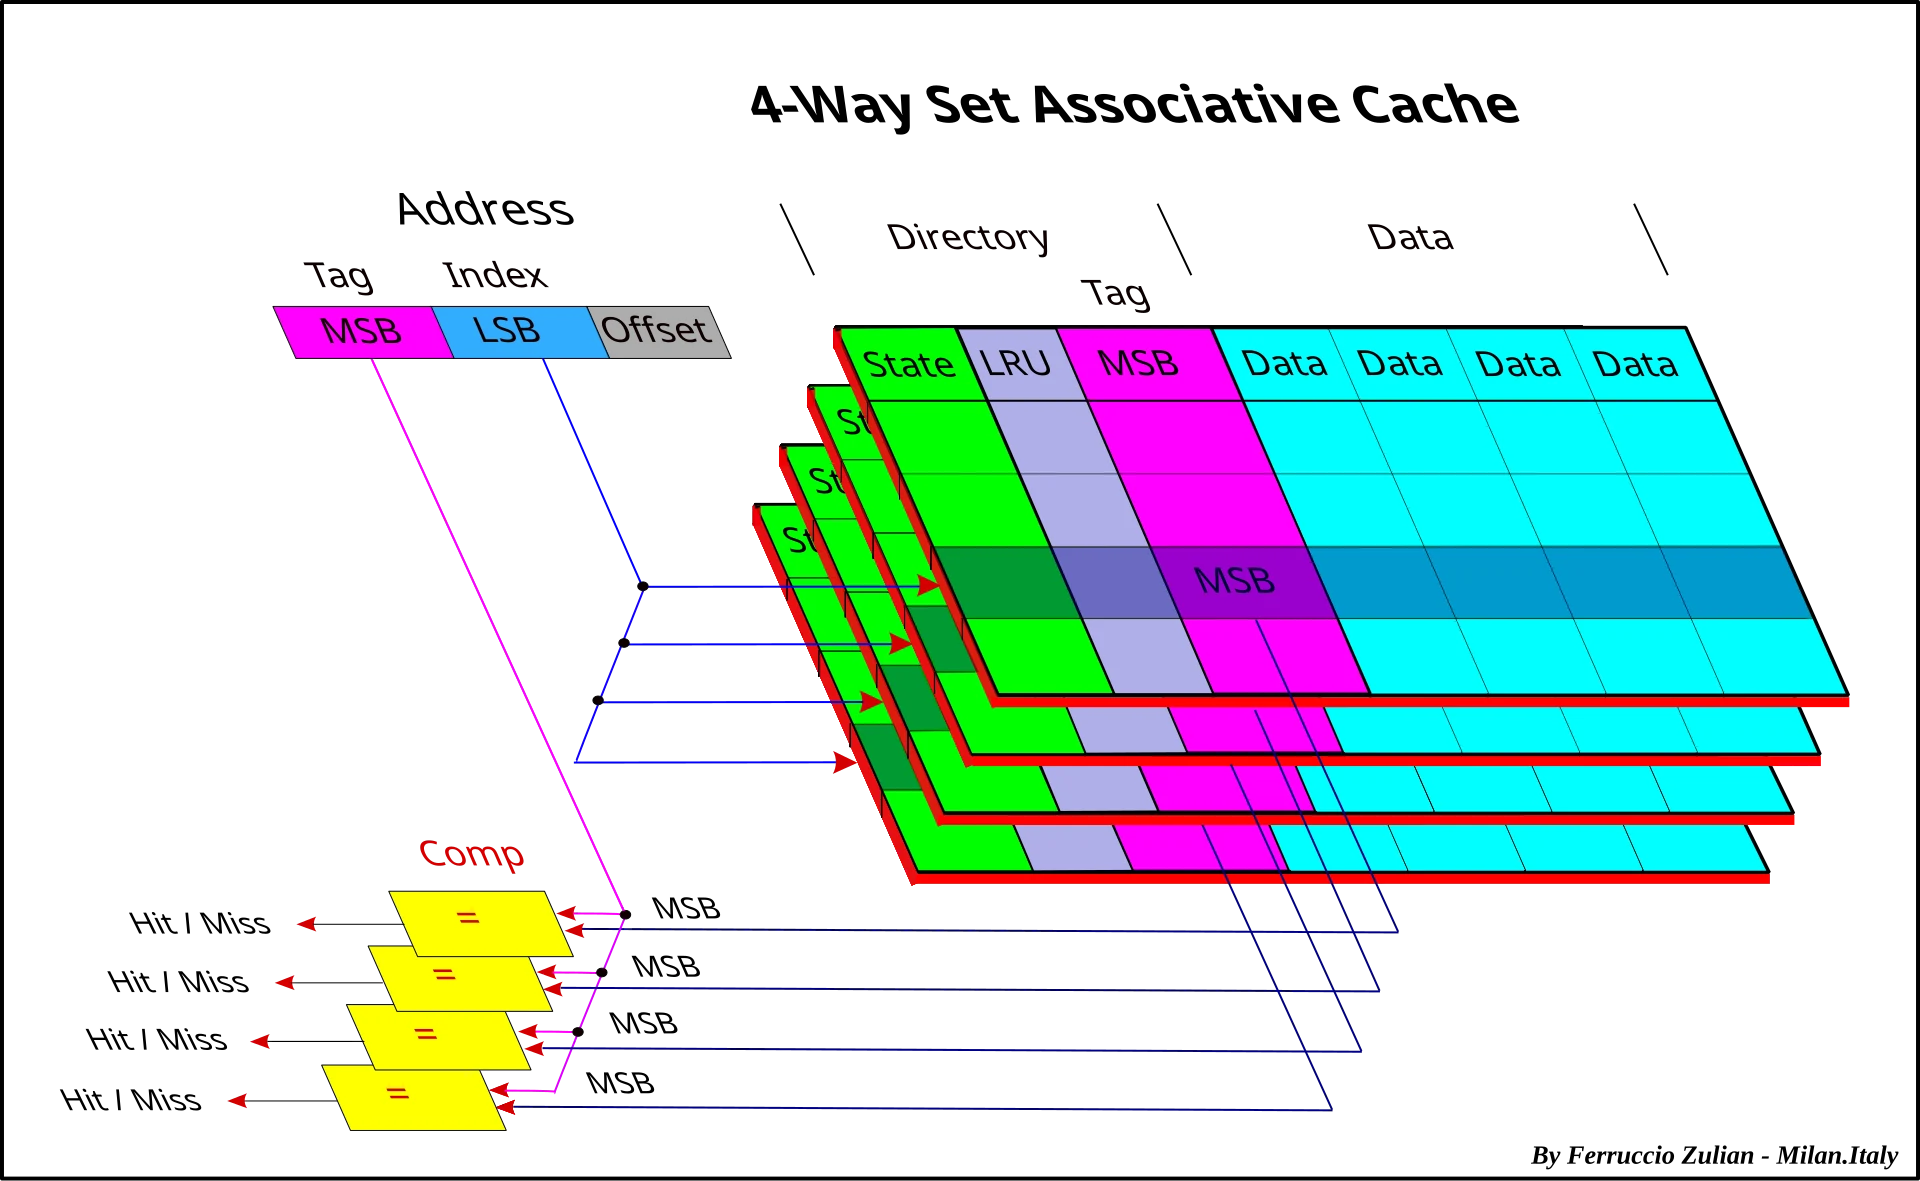
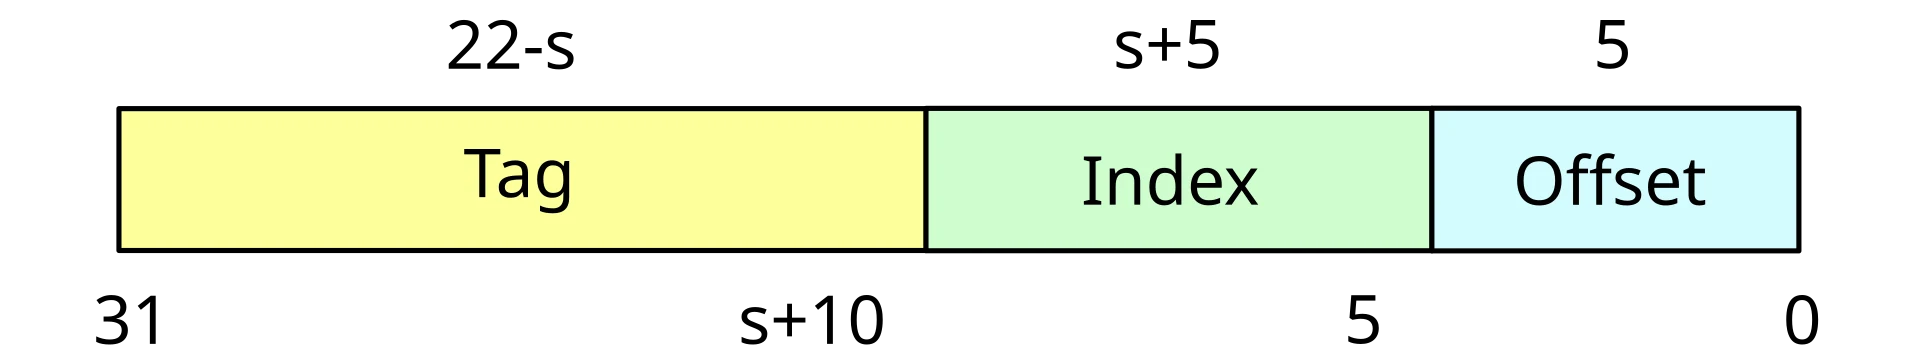
例:主存地址 32 位,Cache 采用 4 路组相联,块大小 16 B,共 64 组。 块内地址 =
log₂16 = 4位;组号 =log₂64 = 6位;标记 =32 − 4 − 6 = 22位。 这类题的通用套路:先算块内位数,再算行数/组数位数,剩下的都给标记。
4.6.3 替换算法与写策略
替换算法(直接映射无需替换;组相联/全相联需要):FIFO(先进先出,简单但易淘汰常用块)、LRU(最近最少使用,最贴近局部性)、LFU(最少使用频次)、随机。
写策略:
| 写策略 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 写直达(Write-through) | 同时写 Cache 与主存 | 一致性好、实现简单 | 访存流量大,需写缓冲 |
| 写回(Write-back) | 只写 Cache,置"脏位",被替换时才写主存 | 减少访存 | 一致性维护复杂 |
4.6.4 多级 Cache
现代 CPU 用 L1(分指令/数据)、L2、L3 三级:L1 最小最快、L3 容量大且多核共享。
4.7 虚拟存储器
虚拟存储器由主存 + 辅存两级构成,目标是让程序员看到一个远大于物理内存的逻辑地址空间,并支持多道程序互不干扰。
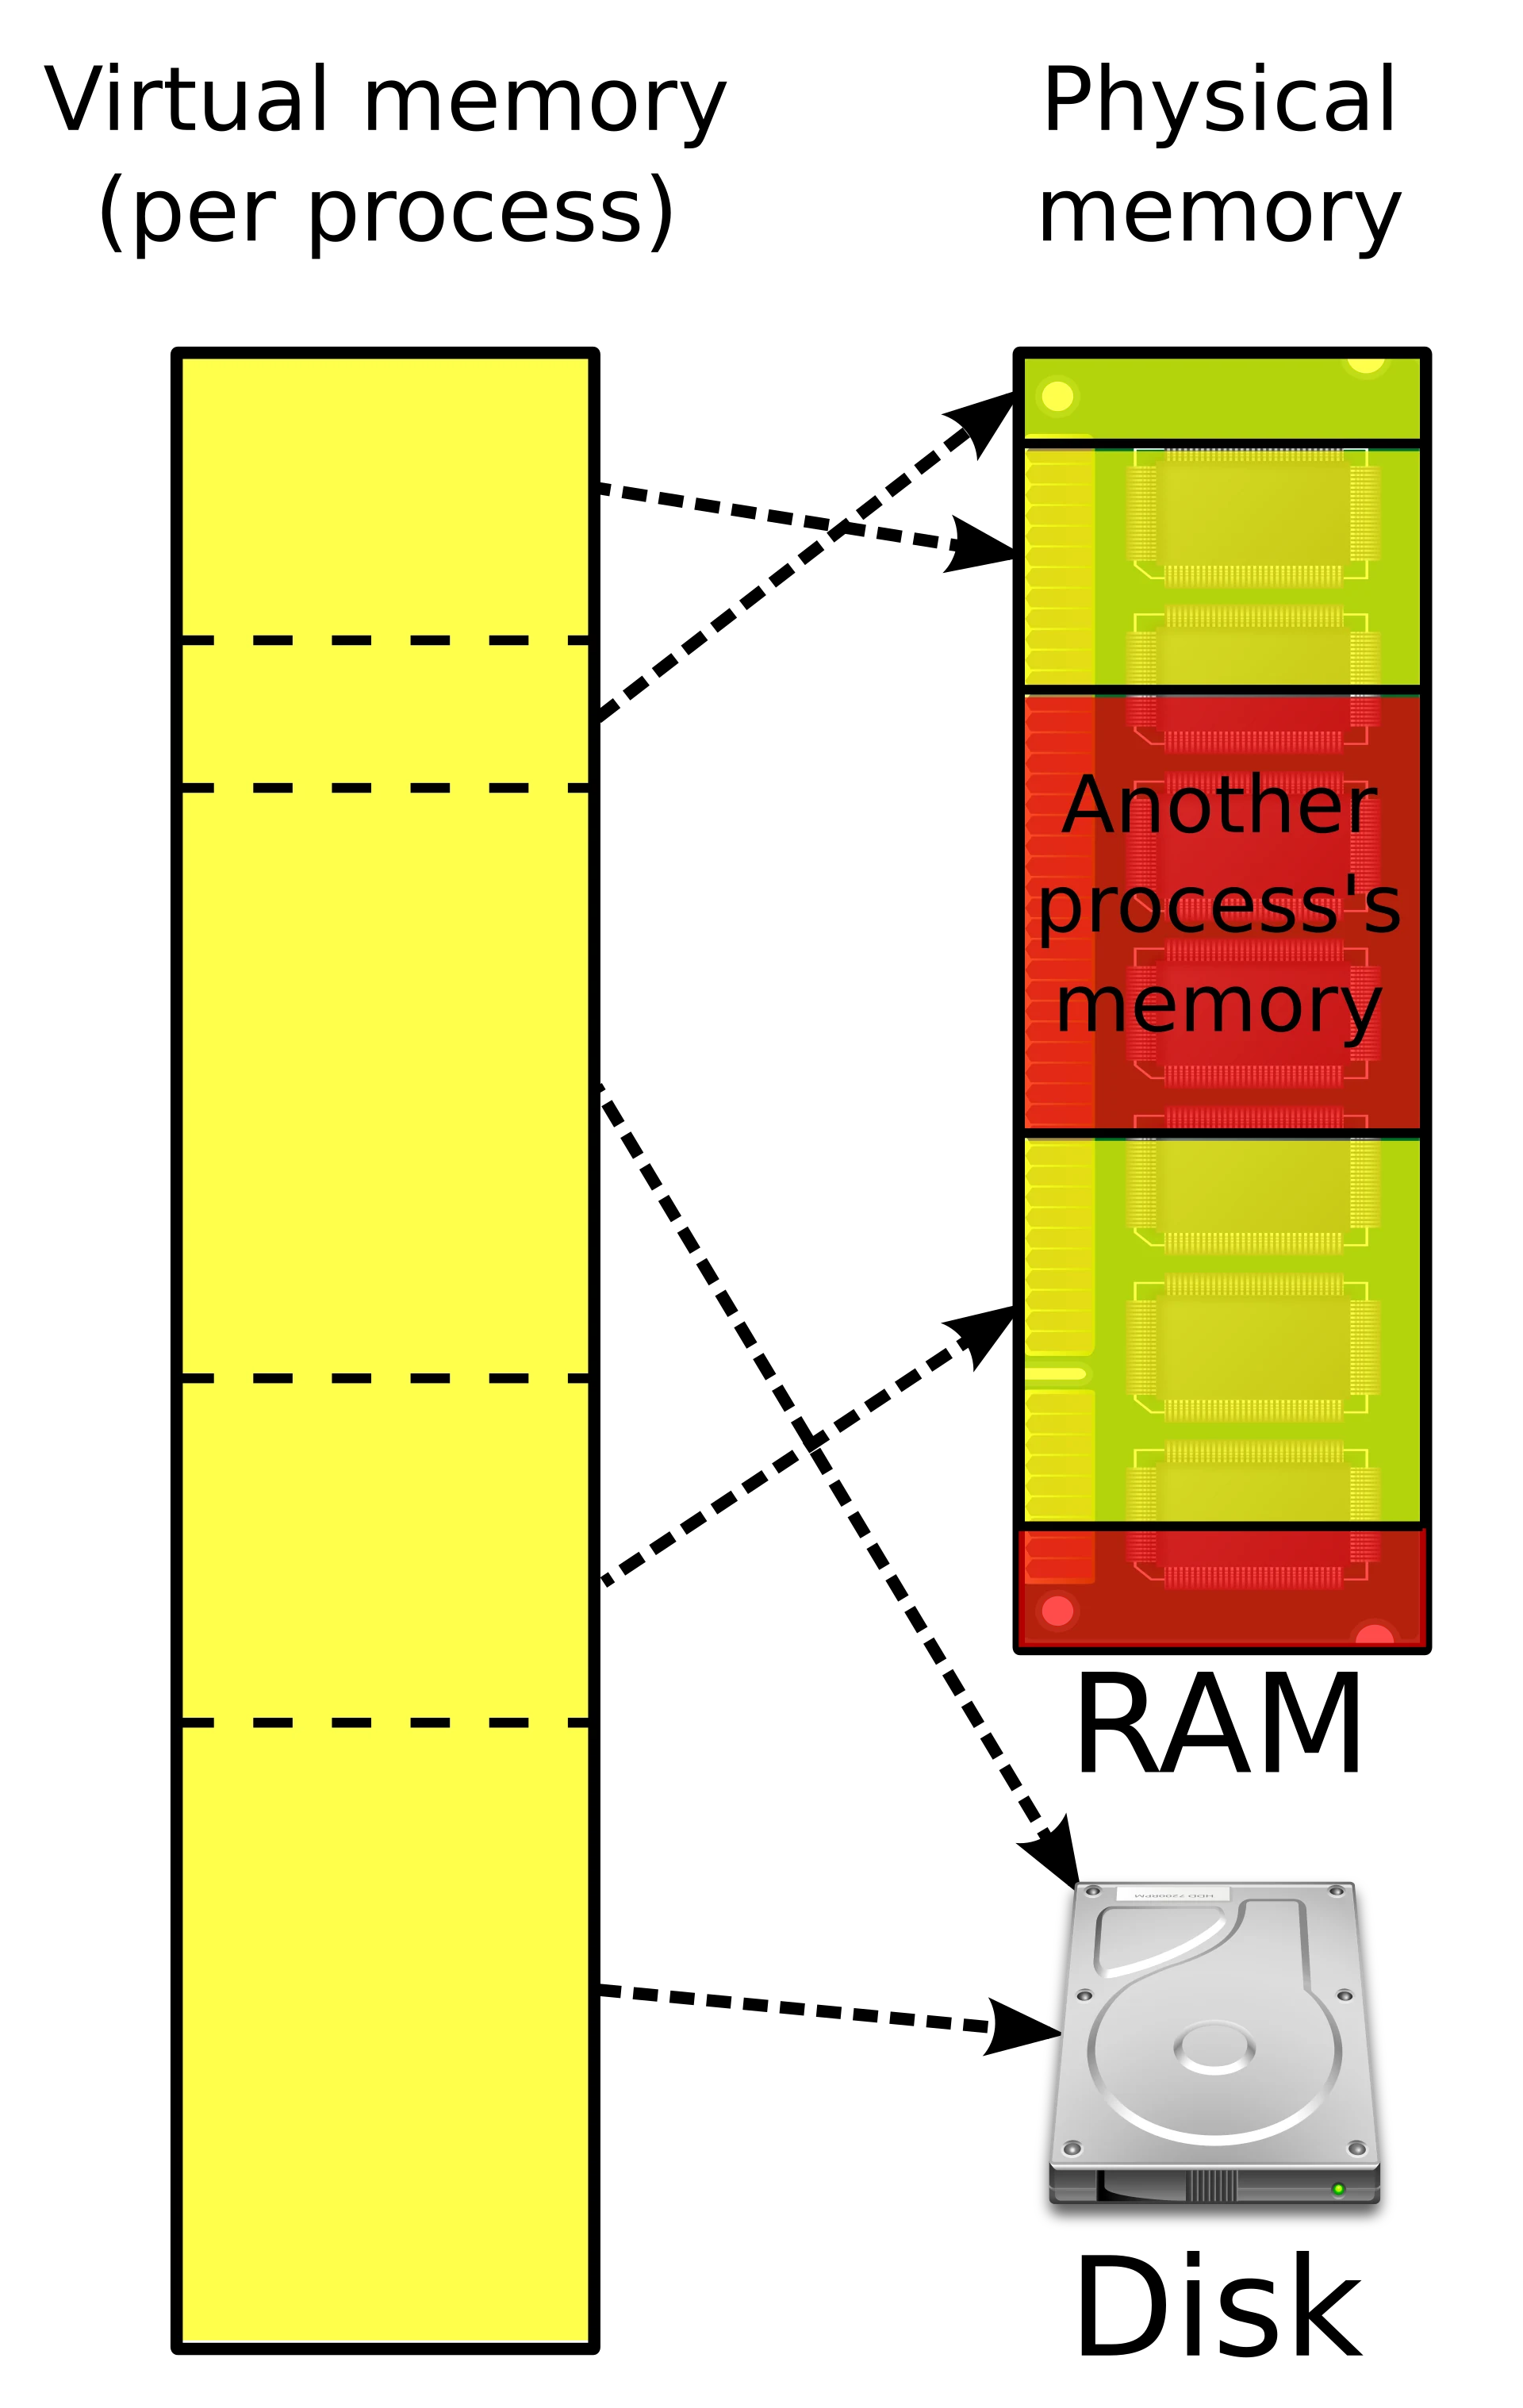
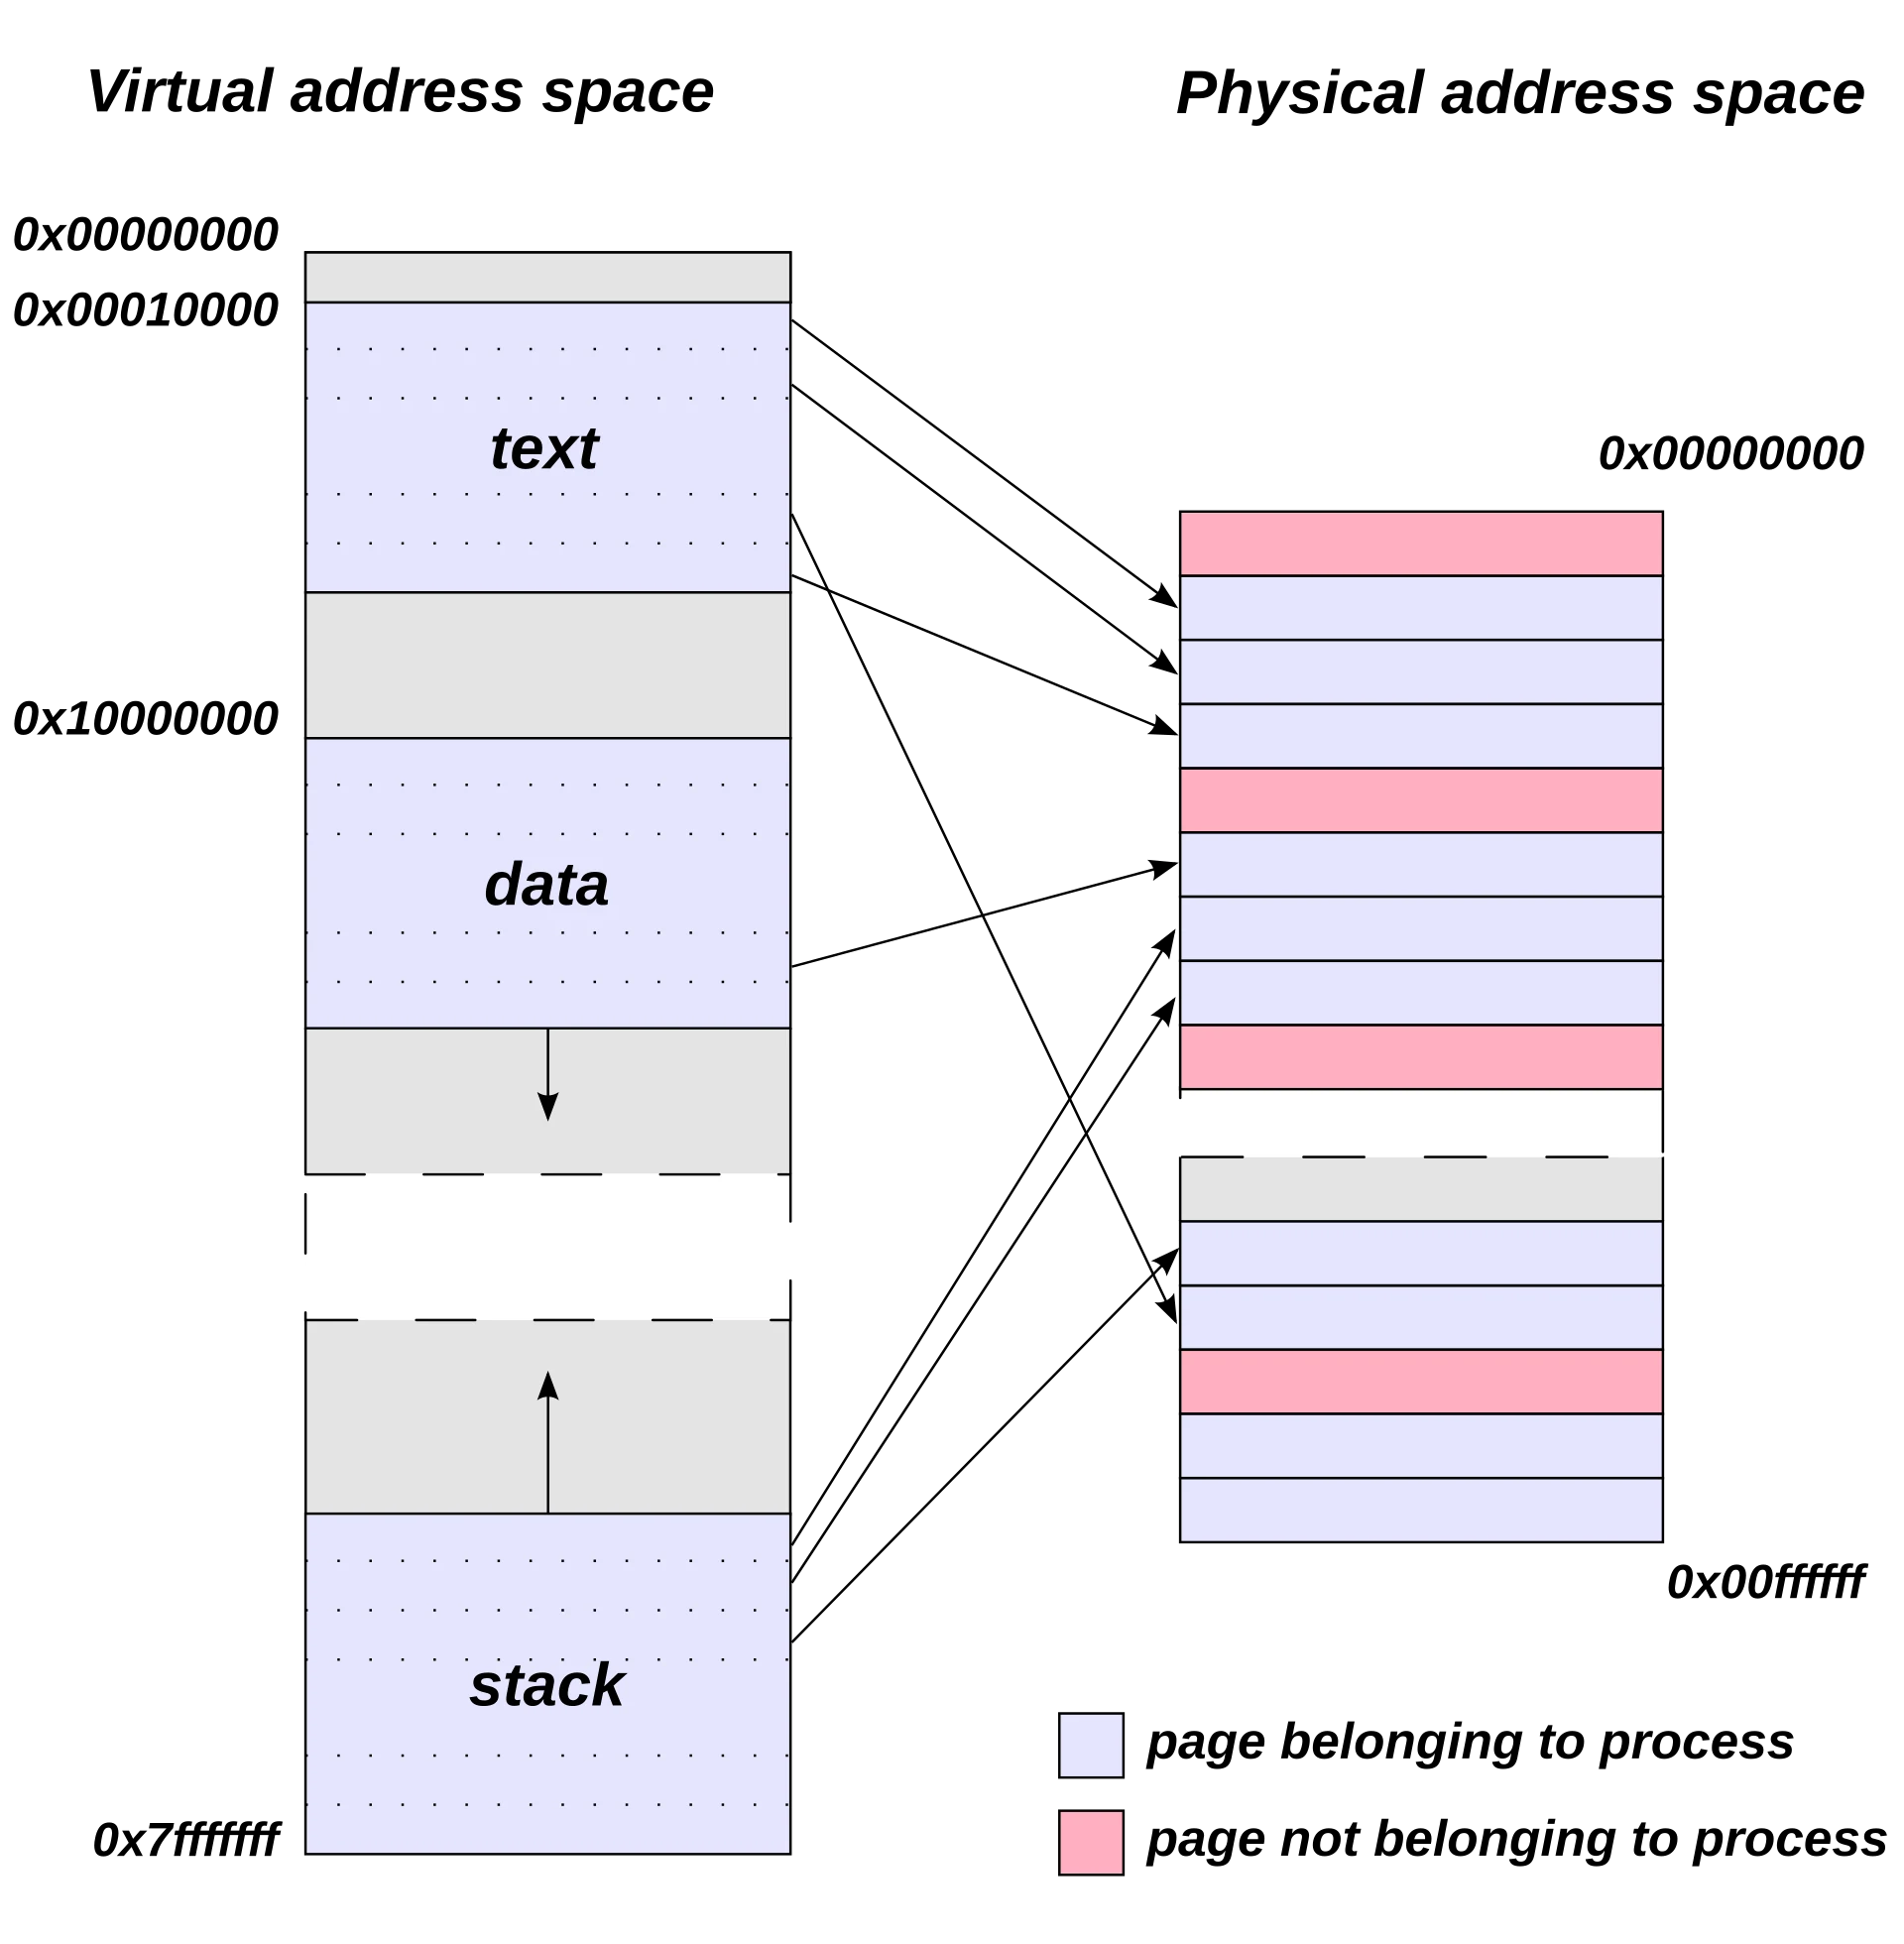
4.7.1 页式虚拟存储器与地址变换
虚地址划分为虚页号 + 页内地址,经页表把虚页号映射为物理页号,再拼上页内地址得到物理地址。多级页表用于压缩页表体积。
TLB(快表) 是页表项的硬件高速缓存,用来加速地址变换:
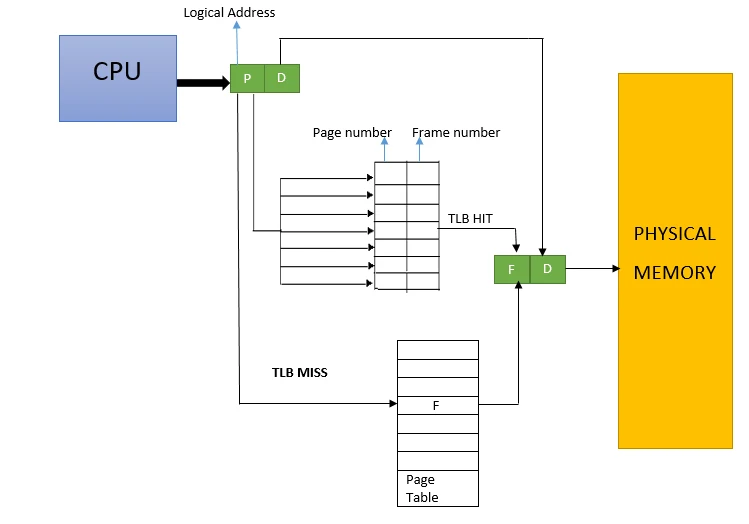
地址变换流程:查 TLB → 命中则直接得到物理页号;未命中则查页表 → 更新 TLB。
| 对比 | Cache | 虚拟存储器 |
|---|---|---|
| 缓存对象 | 主存中的数据块 | 主存与辅存间的页/段 |
| 管理者 | 纯硬件 | 硬件 + 操作系统 |
| 目的 | 提高访存速度 | 扩大逻辑空间、多道程序保护 |
| 缺失代价 | 访问主存(约百纳秒) | 访问磁盘(约毫秒级,高 5~6 个数量级) |
例:虚地址 32 位、页大小 4 KB。页内地址 12 位、虚页号 20 位,页表项数 =
2^20 = 1M;若每项 4 B,页表大小 = 4 MB。
4.8 典型题
题 1(Cache 地址划分):某 Cache 共 4K 行、块大小 64 B,直接映射,主存 32 位,求各字段位数。
解:块内 = log₂64 = 6 位;行号 = log₂4096 = 12 位;标记 = 32 − 6 − 12 = 14 位。
题 2(平均访问时间):Cache 存取 5 ns,主存 50 ns,命中率 0.9。求平均访问时间。
解:Ta = 0.9×5 + 0.1×50 = 4.5 + 5 = 9.5 ns。
题 3(存储器扩展):用 16K × 4 的芯片构成 64K × 8 的存储器,需要多少片?地址如何分配?
解:片数 = (64K/16K) × (8/4) = 4 × 2 = 8 片。64K 需 16 位地址;片内 16K 用 14 位(A0~A13);A14、A15 接译码器产生 4 组片选,每组两片并联完成位扩展。
题 4(磁盘):磁盘共 8 个盘面、每面 1000 条磁道、每道 64 个扇区、每扇区 512 B,求容量。
解:8 × 1000 × 64 × 512 B = 262 144 000 B ≈ 250 MB。
更多练习:见附录 C 自测清单。
5. 第 5 章 总线与 I/O 子系统
本章回答"各部件怎么连起来、数据怎么高效搬运"。主线:总线(通道)→ 四种传送控制方式(PIO、中断、DMA、IOP)。
5.1 I/O 子系统概述
I/O 子系统由 I/O 设备、I/O 接口、总线三部分组成。设备与主机在速度、数据格式、控制方式、时序上差异巨大(如 CPU 纳秒级、键盘毫秒级),必须由 I/O 接口居中协调。
I/O 接口的典型功能:
| 功能 | 说明 |
|---|---|
| 数据缓冲 | 用数据寄存器/缓冲器弥合速度差 |
| 地址译码 | 判断本次访问是否选到自己 |
| 状态记录 | 用状态寄存器反映设备忙/闲/错 |
| 命令控制 | 接收并解释 CPU 发来的命令 |
| 格式与时序转换 | 串/并转换、电平与时序匹配 |
| 中断请求 | 设备就绪时向 CPU 发中断 |
接口内部包含一组端口(数据端口、状态端口、控制端口)。编址方式有两种:统一编址(与主存共用地址空间,用普通访存指令访问,占用内存地址)与独立编址(有专用 I/O 指令与独立地址空间,需专门的输入输出指令)。
5.2 总线
5.2.1 概念与分类
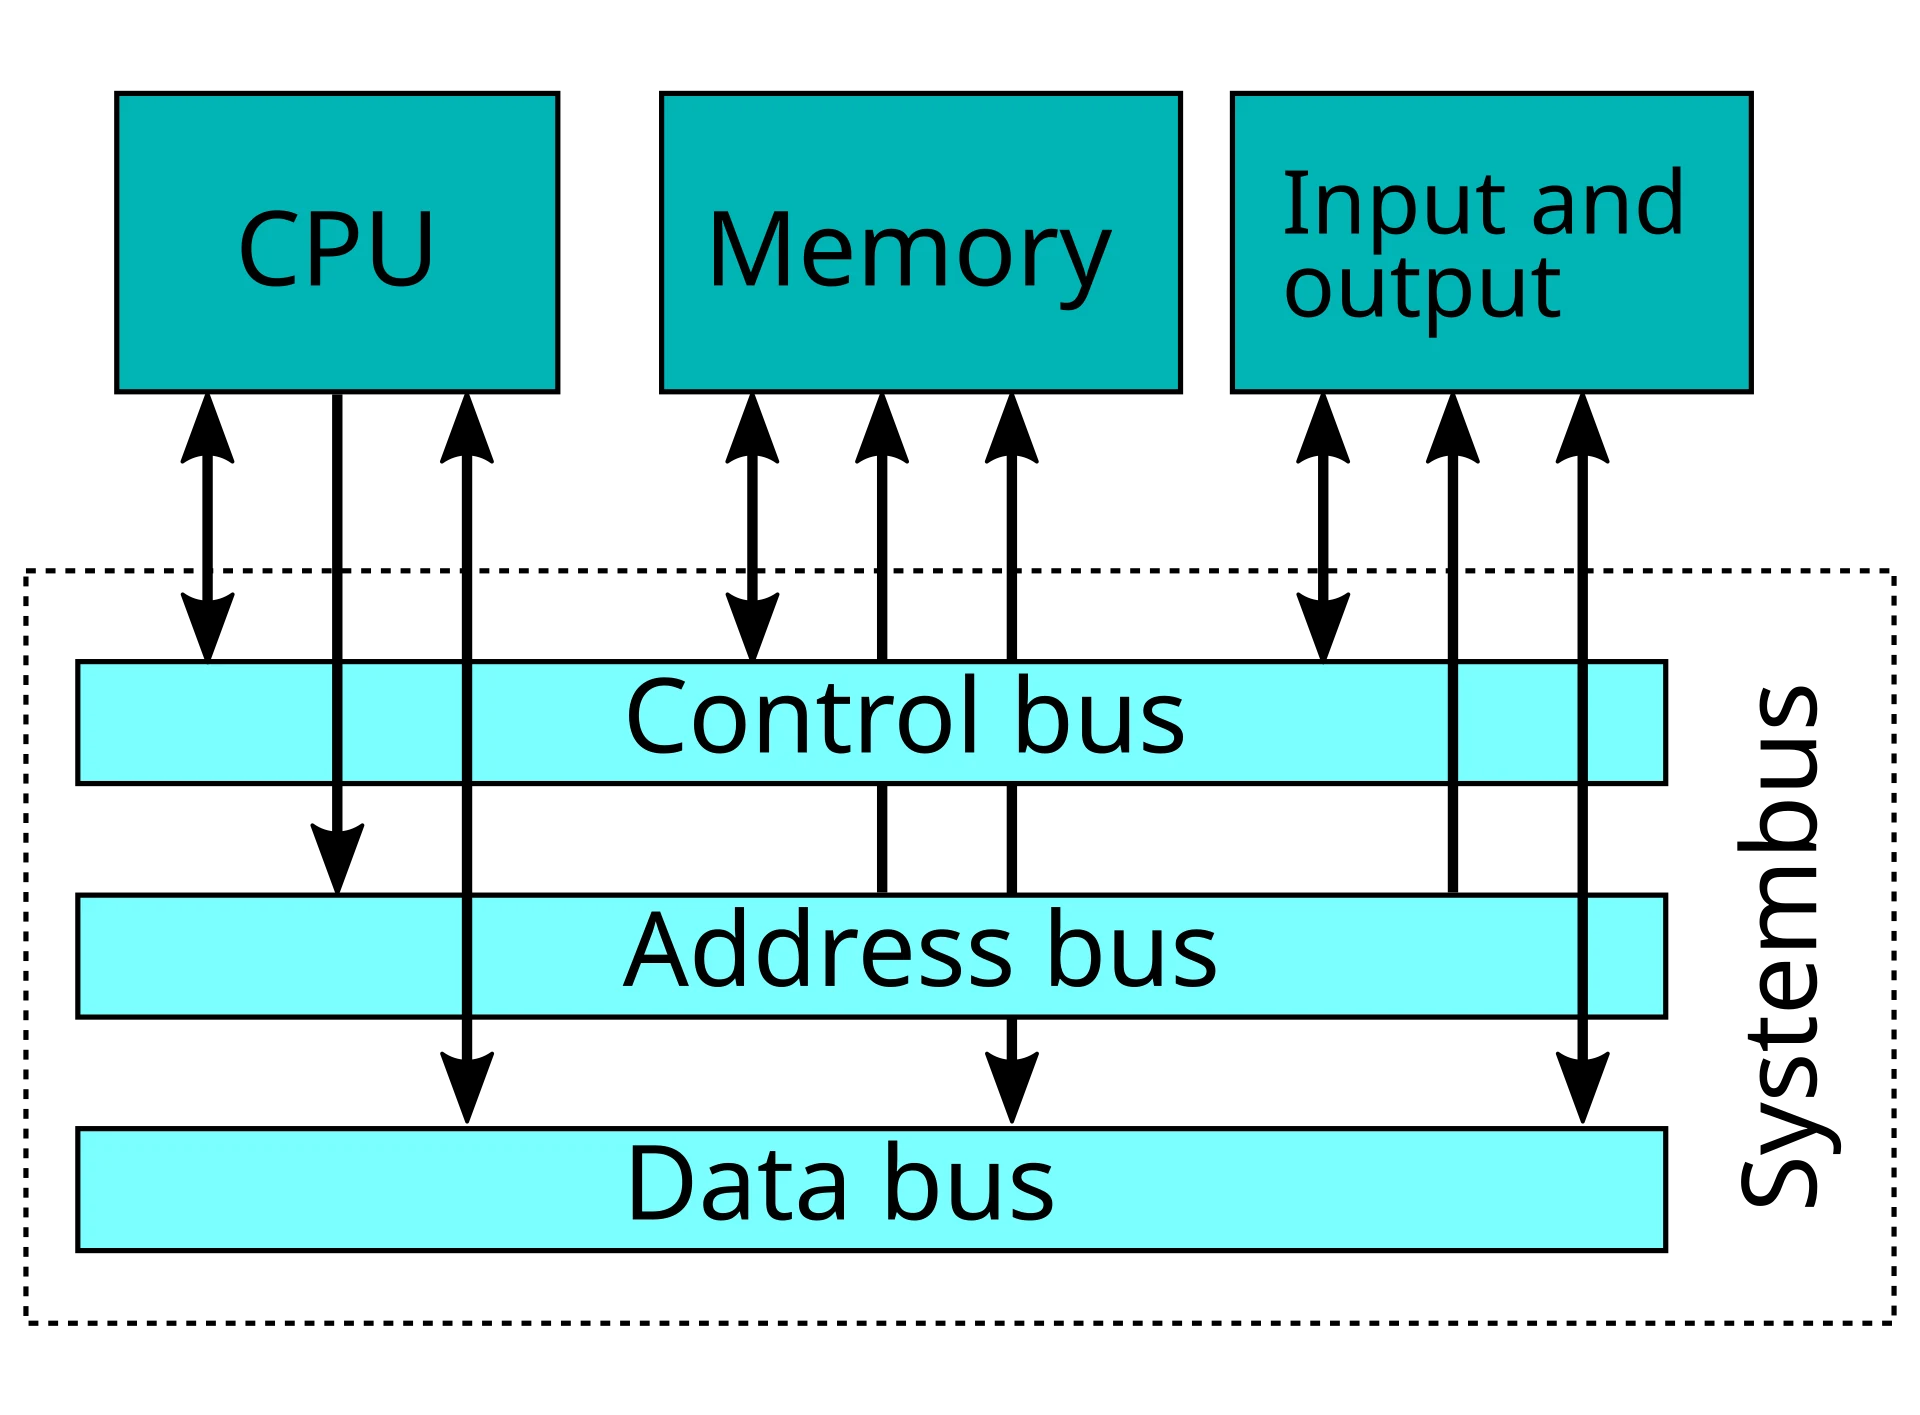
总线是连接多个部件的公共信息传送通道,其特点是分时共享(同一时刻只允许一个部件发送)。
| 分类角度 | 类型 | 说明 |
|---|---|---|
| 位置 | 片内总线 / 系统总线 / 通信总线 | 系统总线又分数据、地址、控制三类 |
| 传输方式 | 串行 / 并行 | 串行省线但慢,并行快但成本高、易受串扰 |
| 时序 | 同步 / 异步 | 见下文 |
三条系统总线的方向性常考:
- 数据总线:双向,宽度与机器字长/存储字长有关;
- 地址总线:单向(CPU → 存储器/接口),宽度决定可寻址空间;
- 控制总线:部分出、部分入,宽度反映控制能力。
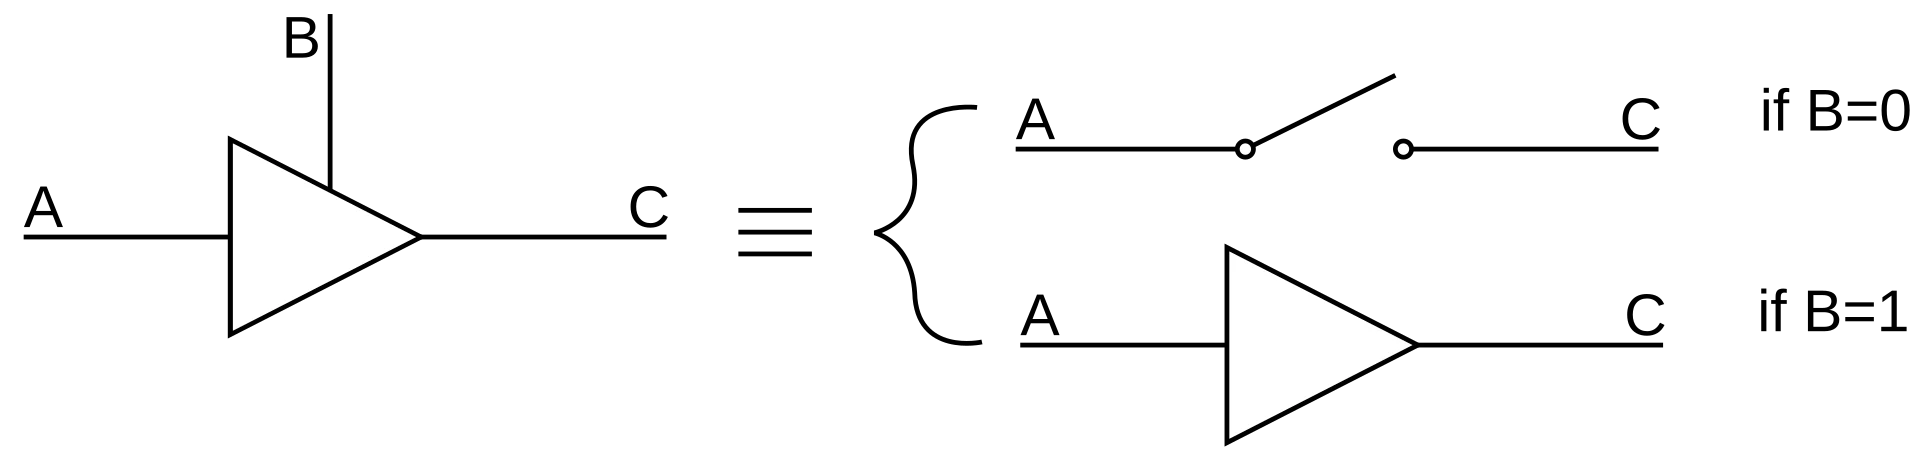
总线上的部件要"能挂上去又不互相干扰",靠三态门(输出高电平、低电平、高阻三种状态):不发言者处于高阻态,相当于从电路上"断开"。
5.2.2 性能指标
总线带宽是最常考的计算:
总线带宽 = 总线宽度(字节) × 每秒可传送次数
例 1:总线宽度 32 位、时钟频率 66 MHz、每个时钟周期传送一次 →
4 B × 66×10⁶ = 264 MB/s。 例 2:总线宽度 16 位、时钟 8 MHz,但每 2 个时钟周期才能传送一次 →2 B × 8×10⁶/2 = 8 MB/s。做题必须先确认"每个时钟传送几次",这是最常见的失分点。
5.2.3 总线仲裁(谁用总线)
多个主设备同时请求时,由仲裁器决定使用权。集中式三种方式:
| 方式 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 链式查询 | 授权信号沿设备链依次传递 | 线少、最简单 | 优先级固定,对高优先级有利、故障敏感 |
| 计数器定时查询 | 计数器计到请求设备号时授权 | 优先级可灵活改变 | 多一组计数线,速度居中 |
| 独立请求 | 每个设备有独立的请求/授权线 | 响应最快、优先级灵活 | 线多、控制最复杂 |
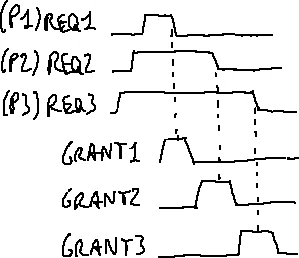
分布式仲裁把仲裁逻辑分散到各设备,无需中央仲裁器。
5.2.4 总线定时
| 定时方式 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 同步定时 | 统一时钟,各事件在固定节拍发生 | 简单、速度快 | 受最慢设备牵制,无法适应速度差异大的设备 |
| 异步定时 | 请求—应答握手(Request/Ack) | 灵活,能兼容快慢设备 | 控制复杂,握手有额外开销 |
异步握手又分:不互锁(主方发出请求后不等回答就撤销)、半互锁(请求保持到收到回答,回答不等撤销)、全互锁(双方都等对方撤销,最可靠最慢)。
5.3 程序传送模式(PIO)
CPU 通过程序主动查询设备状态:读状态寄存器 → 判断"就绪" → 传送数据。分无条件传送(设备始终就绪,如开关量)与条件传送(查询式)。
优点:硬件最简单,无需中断逻辑。缺点:CPU 在等待期间空转,利用率极低;且 CPU 与设备不能并行。
5.4 中断模式
5.4.1 基本概念
设备就绪时主动向 CPU 发出中断请求,CPU 执行完当前指令后响应,暂停原程序转去执行中断服务程序,处理完再返回。CPU 与设备可以并行工作,效率显著高于查询方式。
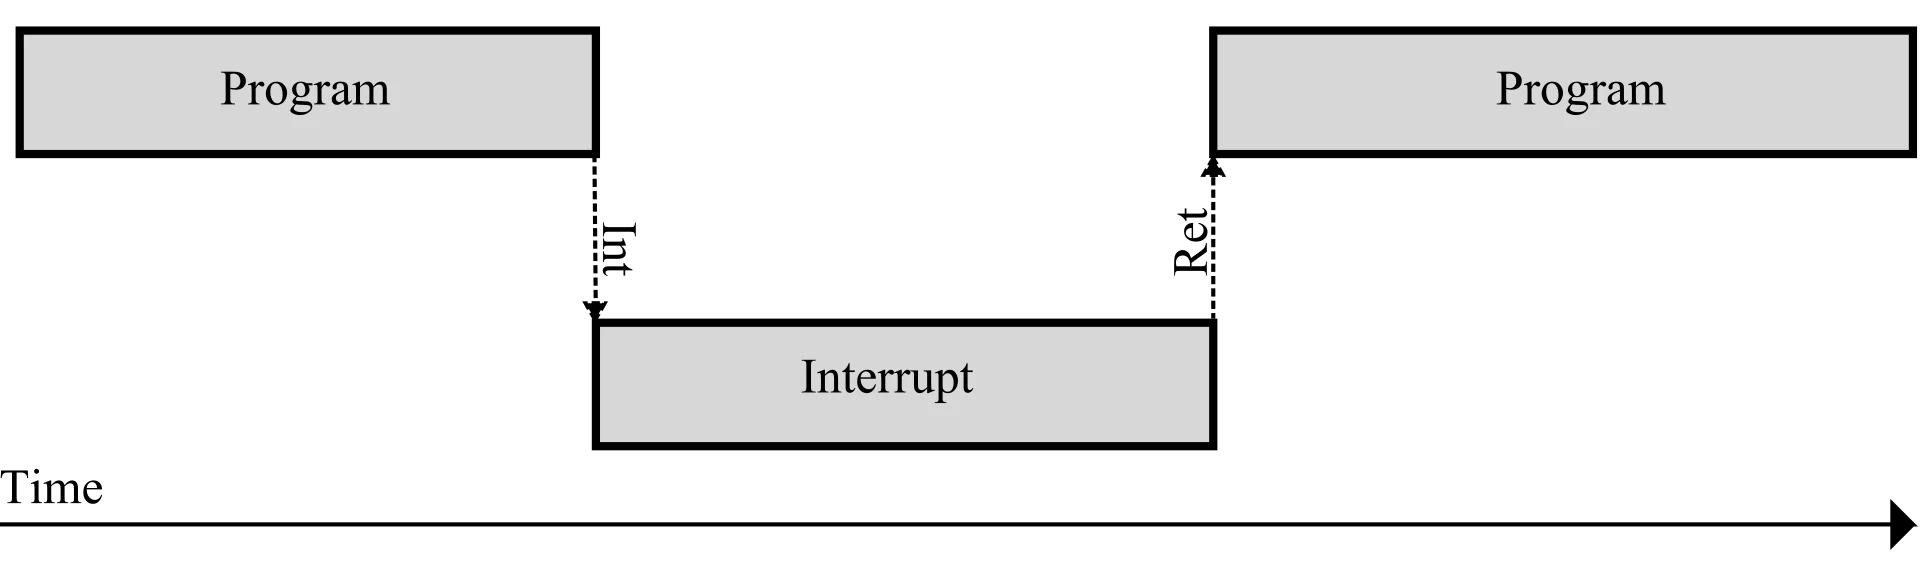
中断按来源分内中断(异常)与外中断(I/O 中断、时钟中断等);按可否屏蔽分可屏蔽中断与不可屏蔽中断。
5.4.2 中断处理流程(必背)
中断响应条件:① 有中断请求;② CPU 允许中断(开中断);③ 当前指令执行完毕。
处理流程:
- 关中断(防止响应过程被打断);
- 保存断点(把 PC 与 PSW 压栈);
- 识别中断源(软件查询或硬件向量);
- 转入中断服务程序(保护现场后执行服务);
- 恢复现场、开中断、返回断点(中断返回指令)。
中断优先级决定多个请求同时到来时先服务谁;中断屏蔽字决定当前服务程序允许哪些中断打断自己(实现中断嵌套)。
例:四个中断源优先级 A > B > C > D,屏蔽字中
1表示屏蔽、0表示开放。为保证"高优先级可打断低优先级、低优先级不能打断高优先级",各级服务程序应设置:
| 服务程序 | A | B | C | D |
|---|---|---|---|---|
| A | 1 | 1 | 1 | 1 |
| B | 0 | 1 | 1 | 1 |
| C | 0 | 0 | 1 | 1 |
| D | 0 | 0 | 0 | 1 |
中断向量:每个中断源对应一个固定地址(向量),CPU 按向量取服务程序入口。**多重中断(中断嵌套)**指服务程序执行期间响应更高优先级请求。
5.5 DMA 模式
DMA(直接存储器存取) 由专门的 DMA 控制器接管总线,在主存与设备之间直接成块搬运数据,不需要 CPU 逐字干预。
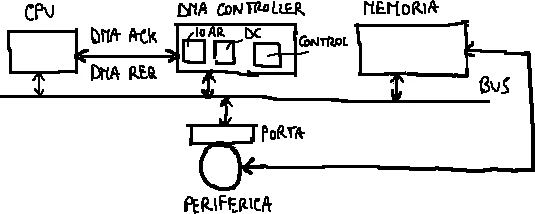
三种数据交换方式(DMA 与主存争用总线时):
| 方式 | 做法 | 特点 |
|---|---|---|
| 停止 CPU 访存 | DMA 传送期间 CPU 完全停访存 | 简单,但 CPU 效率受损 |
| 周期挪用(周期窃取) | DMA 每传一个字/字节挪用一次总线周期 | 最常用,兼顾双方 |
| DMA 与 CPU 交替访存 | 把存取周期分给两者交替使用 | 无需申请总线,效率高但硬件复杂 |
DMA 与中断的区别(必背):
| 对比 | 中断方式 | DMA 方式 |
|---|---|---|
| 数据传送单位 | 一个字/字节 | 数据块 |
| 是否经过 CPU | 经 CPU 参与 | 不经过 CPU,直接主存 ↔ 设备 |
| CPU 介入时刻 | 每次传送都需响应 | 只在开始初始化与结束 |
| 优先级 | 低于 DMA | DMA 请求优先级更高 |
| 适用场合 | 低速、随机、少量 | 高速、成块、大量 |
例:磁盘以 2 MB/s 向主存传送 4 KB 数据,DMA 传送时间 =
4096 B / 2×10⁶ B/s ≈ 2 ms;这 2 ms 中 CPU 可继续执行其它程序,只在传送结束后响应一次 DMA 完成中断。
把三种方式放在同一时间轴上对比,CPU 的"有效工作比例"一目了然:
5.6 IOP 与 PPU
| 模式 | 说明 |
|---|---|
| IOP(输入输出处理机)/ 通道 | 有自己的指令系统,能执行通道程序,一次控制一批设备的成组数据传送;CPU 只需发一条 I/O 指令 |
| PPU(外围处理机) | 功能更强的 I/O 专用处理机,可分担设备管理、码制转换、差错处理等任务,进一步解放 CPU |
从 PIO → 中断 → DMA → IOP/PPU,本质是CPU 对 I/O 干预程度逐级下降,并行度逐级提高。
5.7 典型题
题 1(总线带宽):某总线数据线 64 位,工作频率 133 MHz,每个时钟周期传送 2 次数据,求带宽。
解:8 B × 133×10⁶ × 2 = 2128 MB/s ≈ 2.1 GB/s。
题 2(中断流程):写出 CPU 响应中断后的前四步操作。
解:关中断 → 保存断点(PC/PSW 压栈)→ 判别中断源(取中断向量)→ 转入中断服务程序。
题 3(DMA):为什么 DMA 的优先级通常高于中断?
解:DMA 与主存/设备之间的数据是一个字一个字连续传送的,若被中断打断,可能造成数据丢失或设备缓存溢出。因此 DMA 请求通常设为最高优先级(或与 CPU 交替使用总线),以保证传输不中断。
更多练习:见附录 C 自测清单。
6. 第 6 章 I/O 设备及其接口
本章以记忆为主,重点是各类设备的工作原理、关键参数与常见计算。
6.1 概述
I/O 设备实现人与计算机、计算机与外部世界的信息交换,其功能可归纳为信息转换(把外部信息变成机内形式,或反之)与人机交互。设备通过接口与主机相连,接口负责"速度匹配、格式转换、控制信号转换"。
按信息传送方向分为输入设备、输出设备、输入输出兼用设备(磁盘、终端);按信息形态分为字符设备与块设备。
6.2 键盘
键盘是典型输入设备,核心是矩阵扫描:把按键排成行列矩阵,主机通过逐行/逐列扫描判断哪个键被按下。
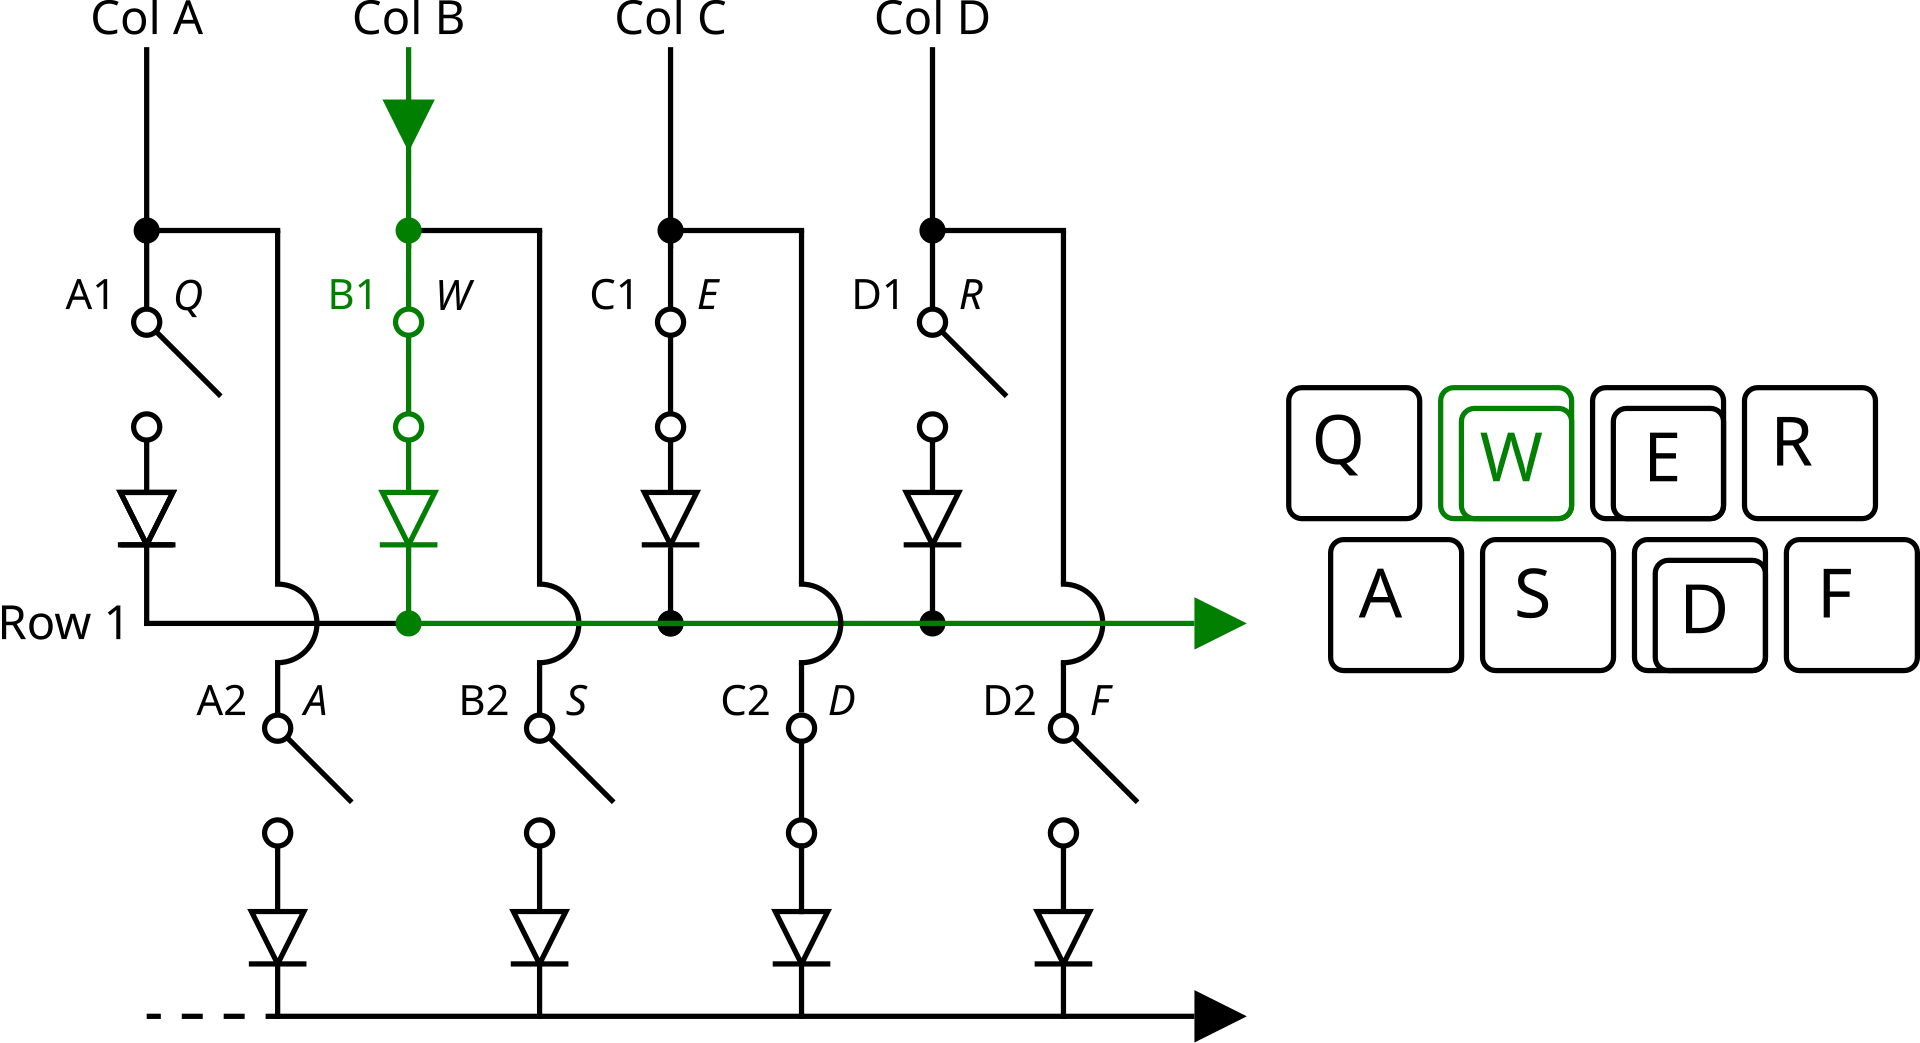
需要处理两个问题:
- 抖动(bounce):机械触点闭合时会多次弹跳,用硬件(RC 滤波、触发器)或软件(延时重读)去抖;
- 键码转换:把位置信息(扫描码)转换为可用编码(如 ASCII 或系统键码)。
6.3 显示器件
CRT(阴极射线管):电子束轰击荧光屏发光,按光栅扫描一行行绘制,需要不断刷新才能维持画面。
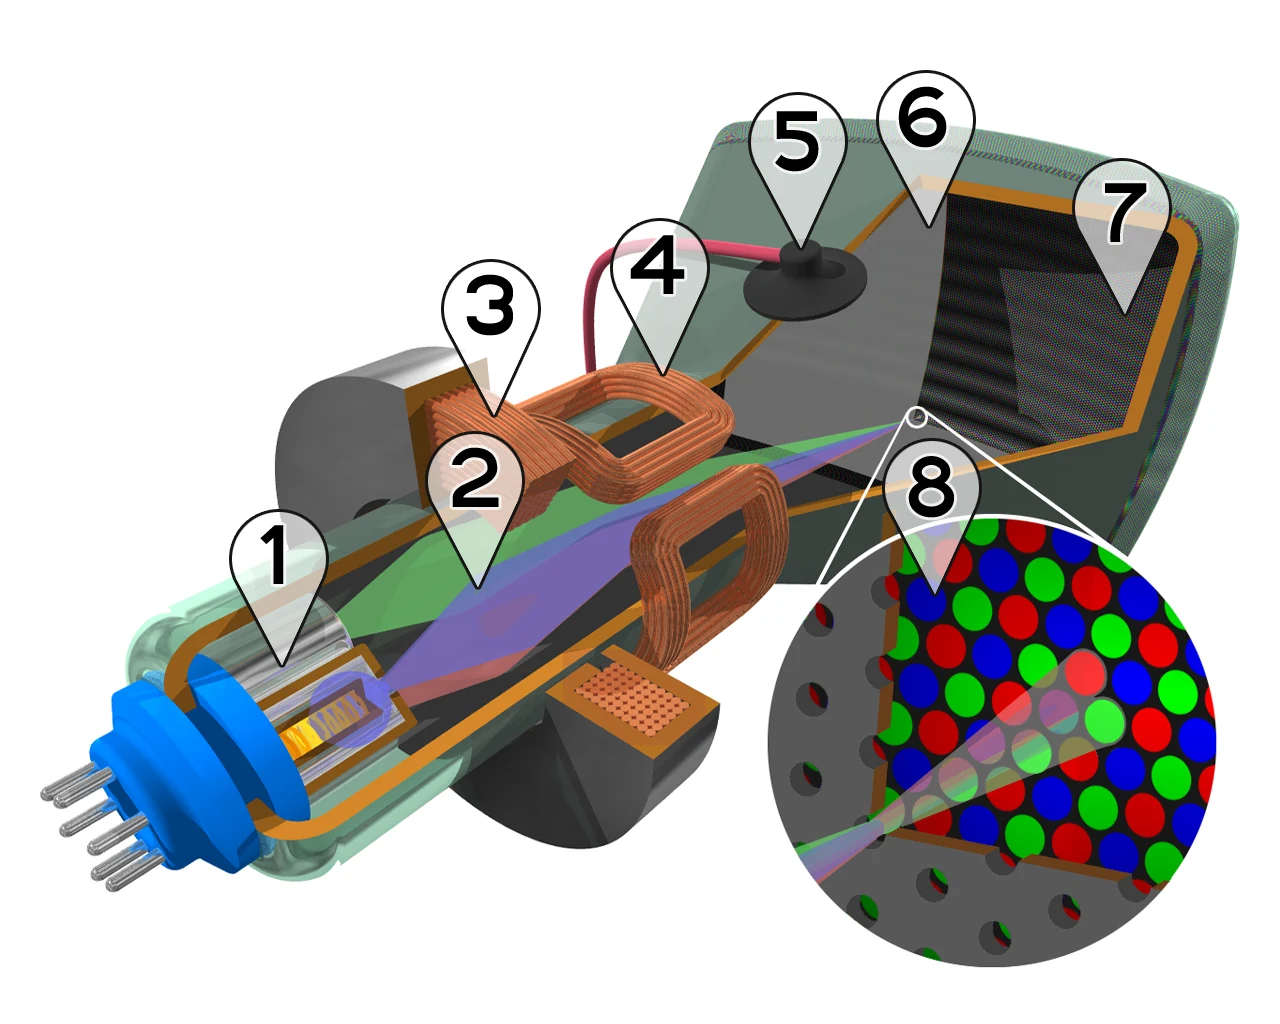
LCD(液晶显示器):利用液晶分子在电场下改变透光性成像,依靠背光 + 偏振工作,薄、轻、省电,是当代主流;TFT 表示每个像素由薄膜晶体管独立控制,响应更快、画质更好。
关键参数与常考计算:
| 参数 | 含义 |
|---|---|
| 分辨率 | 水平 × 垂直像素数 |
| 点距 | 相邻像素中心距离 |
| 刷新率 | 每秒重绘次数(Hz) |
| 灰度/色彩深度 | 每像素位数,如 24 位真彩色 |
显存容量计算:显存容量 = 水平分辨率 × 垂直分辨率 × 每像素位数 / 8。
例:1920 × 1080、24 位真彩色 →
1920 × 1080 × 24 / 8 B = 5.93 MB,即至少约 6 MB 显存(若采用双缓冲则再乘 2)。
6.4 打印设备
| 类别 | 代表 | 原理 | 特点 |
|---|---|---|---|
| 击打式 | 点阵打印机 | 打印针撞击色带 | 可复写、噪音大、慢 |
| 非击打式 | 激光打印机 | 激光成像 + 静电吸附墨粉 + 加热定影 | 快、清晰、无噪音 |
| 非击打式 | 喷墨打印机 | 喷嘴喷射墨滴 | 彩色成本低、速度适中 |
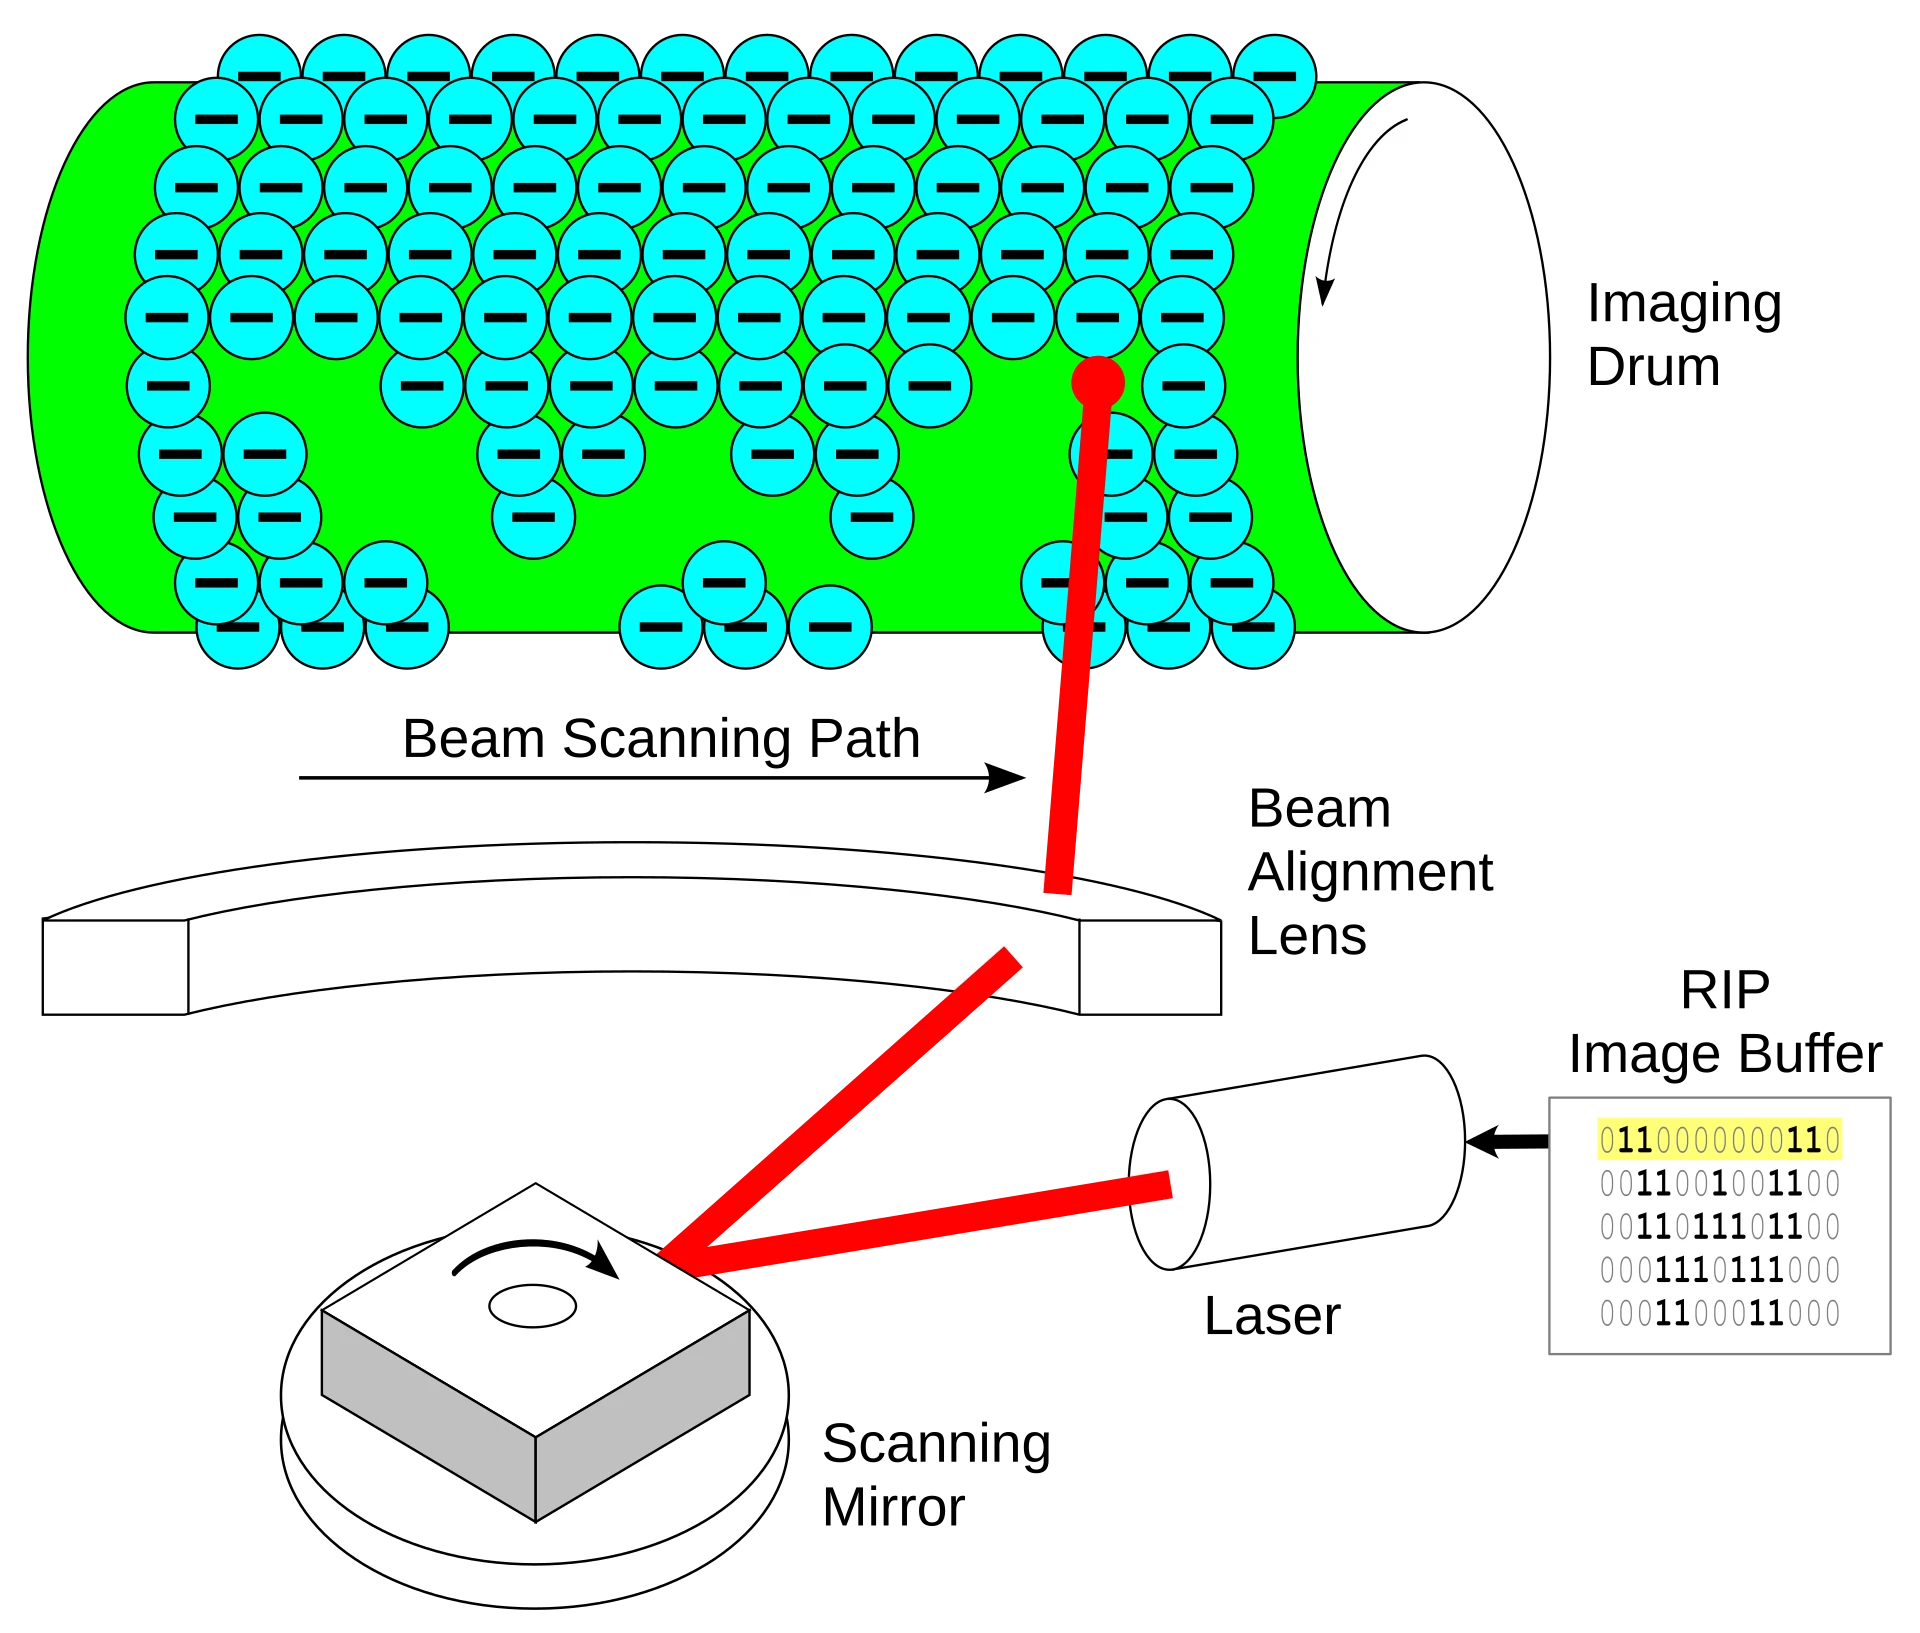
打印速度常用 CPS(字符/秒)或 PPM(页/分钟)表示。
6.5 典型题
题 1(显存):分辨率 1024 × 768、8 位灰度,单缓冲显存至少多大?
解:1024 × 768 × 8 / 8 = 786 432 B = 768 KB。
题 2:为什么激光打印机比点阵打印机快?
解:激光打印机以"页"为单位整页成像,感光鼓转速快、无机械击打;点阵打印机靠打印针逐列撞击,机械惯性限制了速度。
更多练习:见附录 C 自测清单。
附录 A 配图版权与来源
本资料的配图分两类:
- 开放版权原理图:取自 Wikimedia Commons 等公共资源(下表逐图列出出处与许可证)。均为无水印原图,按 CC 系列许可证保留署名,供学习与非商业传播使用。
- 自绘示意图:数据通路、微程序控制器、系统层次结构、寻址方式、Cache 映射与地址字段、存储器扩展、补码钟表、指令周期、五级流水线时空图、三种 I/O 传送方式对比等图为本站原创绘制,可自由使用。
| 图片文件 | 原始文件(Wikimedia Commons) | 作者 | 许可证 |
|---|---|---|---|
ex-5stage.webp | 5 Stage Pipeline.svg | Inductiveload | Public domain |
ex-alu-block.webp | ALU block-zh-cn.svg | Donlon (vectorization and translation) based on File:ALU blo… | CC BY-SA 4.0 |
ex-alu-datapaths.webp | ALU data paths.svg | Lambtron | CC BY-SA 4.0 |
ex-barrel-shifter.webp | Barrel shifter function.svg | BattlePeasant | Public domain |
ex-bus-arbitration.webp | Priority bus arbitration.png | Luca Ghio | CC BY-SA 3.0 |
ex-bus.webp | Computer system bus.svg | W Nowicki | CC BY-SA 3.0 |
ex-cache-address.webp | Address direct mapped cache.svg | User:KCVelaga | CC BY-SA 4.0 |
ex-cache-direct.webp | Direct Mapped Cache.svg | Ferry24.Milan | CC BY-SA 4.0 |
ex-cache-setassoc.webp | Set Associative Cache.svg | Ferry24.Milan | CC BY-SA 3.0 |
ex-crc.webp | Crc shift register 1.svg | Biezl | Public domain |
ex-crt.webp | CRT color enhanced.png | grmwnr (homewiki) | CC BY-SA 3.0 |
ex-dma-controller.webp | DMA controller.png | Luca Ghio | CC BY-SA 3.0 |
ex-dram-cell.webp | Original 1T1C DRAM design.svg | Cyferz at English Wikipedia | CC BY 2.5 |
ex-float-general.webp | General floating point.svg | User:Stannered | CC BY-SA 3.0 |
ex-hamming74.webp | Hamming(7,4) as bits.svg | en:User:Cburnett | CC BY-SA 3.0 |
ex-harvard.webp | Harvard architecture.svg | Nessa los | CC BY-SA 3.0 |
ex-hdd-geometry.webp | Hard drive geometry - English - 2019-05-30.svg | Henry Mühlpfordt, png version from 2010: Bagok | CC BY-SA 4.0 |
ex-ieee754-double.webp | IEEE 754 Double Floating Point Format.svg | Codekaizen | CC BY-SA 4.0 |
ex-ieee754-single.webp | IEEE 754 Single Floating Point Format.svg | Codekaizen | CC BY 3.0 |
ex-instruction-cycle.webp | CPT-fetch-execute-MAR-PC-ans1.svg | Pluke | CC0 |
ex-interrupt.webp | Interrupt.svg | Whiteknight at English Wikibooks | CC BY-SA 3.0 |
ex-keyboard-matrix.webp | Matrix scan current flow with diodes.svg | Daniel beardsmore | Public domain |
ex-laser-writing.webp | Laser printer-Writing.svg | en:User:DMahalko, traced by User:Stannered | CC BY 3.0 |
ex-memhierarchy.webp | Computer Memory Hierarchy.svg | ComputerMemoryHierarchy.png: User:Danlash at en.wikipedia.or… | Public domain |
ex-mips-pipeline.webp | MIPS Architecture (Pipelined).svg | Inductiveload | Public domain |
ex-raid0.webp | RAID 0.svg | en:User:Cburnett | CC BY-SA 3.0 |
ex-raid5.webp | RAID 5.svg | en:User:Cburnett | CC BY-SA 3.0 |
ex-regfile.webp | Register File Medium.svg | Whiteknight at English Wikibooks | CC BY-SA 3.0 |
ex-sram6t.webp | SRAM Cell (6 Transistors).svg | Inductiveload | Public domain |
ex-tlb.webp | Translation Lookaside Buffer.png | Aravind krishna | CC BY-SA 4.0 |
ex-tristate.webp | Tristate buffer corrected.svg | Traced by User:Stannered | Public domain |
ex-vm-space.webp | Virtual address space and physical address space relationship.svg | Traced by User:Stannered, original by en:User:Dysprosia | BSD |
ex-vm.webp | Virtual memory.svg | Ehamberg | CC BY-SA 3.0 |
ex-von-neumann.webp | Von Neumann architecture.svg | Chris-martin, Aeroid | CC BY-SA 3.0 |
共 34 张开放版权配图。若你是原作者且不希望被引用,可联系站长删除。
附录 B 易混概念对比汇总(判断与选择常考)
| 对比 | 一句话区分 |
|---|---|
| 原码 vs 补码 | 原码直观但 0 有二义;补码 0 唯一、减法化加法 |
| 移码 vs 补码 | 移码 = 补码符号位取反,便于比较阶码大小 |
| 定点 vs 浮点 | 定点范围小精度固定;浮点范围大、需规格化 |
| 机器字长 vs 存储字长 vs 指令字长 | 一次处理位数 vs 一个存储单元位数 vs 一条指令位数 |
| 码距 d=2 vs d=3 | 只能检 1 位错(奇偶)vs 能纠 1 位错(海明) |
| 单符号位 vs 双符号位判溢出 | 看两同号相加结果变号 vs 看 01/10 |
| 基址 vs 变址寻址 | 基址面向系统(重定位);变址面向用户(数组遍历) |
| 相对寻址的基准 | 是取指后的 PC,不是当前指令地址 |
| CISC vs RISC | 指令多而变长、微程序 vs 指令少而定长、硬布线、宜流水 |
| 硬布线 vs 微程序控制器 | 速度快不灵活 vs 灵活但慢,改微程序即可 |
| 微程序 vs 微指令 vs 微命令 | 一段程序 vs 一条指令 vs 一个控制信号 |
| 指令周期 vs 机器周期 vs 时钟周期 | 层层包含:指令 ⊃ 机器 ⊃ 时钟(节拍) |
| 单周期 vs 多周期 CPU | CPI=1 但时钟取最长指令 vs CPI 大于 1 但时钟更短 |
| SRAM vs DRAM | 触发器/不需刷新/快贵作 Cache vs 电容/需刷新/慢密作主存 |
| 位扩展 vs 字扩展 | 拼数据位(地址并联)vs 译码选片(增加单元数) |
| DRAM 集中 vs 分散 vs 异步刷新 | 有长死区 vs 无长死区但拖慢系统 vs 均匀分散(常用) |
| 直接映射 vs 全相联 vs 组相联 | 固定行 vs 任意行 vs 组内任意行 |
| 写直达 vs 写回 | 每次同步写主存 vs 只写 Cache 置脏位、替换时写回 |
| Cache vs 虚拟存储器 | 缓存主存数据(纯硬件)vs 扩大逻辑空间(硬件+OS) |
| Cache vs TLB | 缓存主存数据块 vs 缓存页表项;都靠局部性 |
| 存储周期 vs 存取时间 | 周期 ≥ 时间,因为读后需要恢复 |
| 同步 vs 异步总线定时 | 统一时钟节拍 vs 握手应答(不互锁、半互锁、全互锁) |
| 链式查询 vs 独立请求仲裁 | 线少简单、优先级固定 vs 线多、最快、优先级灵活 |
| 程序查询 vs 中断 | CPU 空转轮询、不能并行 vs 设备主动打断、可并行 |
| 中断 vs DMA | 传送单位字、经 CPU、每字介入 vs 传送数据块、不经 CPU、首尾介入 |
| 中断 vs 异常 | 外中断(I/O、时钟)vs 内中断(除零、缺页等) |
| 屏蔽 vs 不可屏蔽中断 | 可用中断屏蔽字禁止 vs 必须响应(如电源故障) |
| 统一编址 vs 独立编址 | 与主存共用地址空间 vs 专有 I/O 指令与地址空间 |
| 分辨率 vs 刷新率 | 像素数量 vs 每秒重绘次数 |
附录 C 考前自测清单
第 1 章
- 能默写冯·诺依曼体制的四条基本思想与五大部件的分工
- 能说出冯·诺依曼结构与哈佛结构的区别及各自适用场景
- 能画出/说出计算机系统的多级层次结构及各级翻译方式
- 会算 CPU 执行时间与 MIPS,能解释"主频高不一定更快"
- 会用 Amdahl 定律算整体加速比
第 2 章
- 原码/反码/补码/移码互求(含 8 位与 16 位各一题)
- 能解释"为什么用补码",能写出 n 位补码范围
- 定点小数的表示范围与精度会算
- IEEE 754 单/双精度的编码与译码各做过一题(含偏置与隐含位)
- 能说出 E、M 全 0/全 1 时的四种特殊值
- 区位码 → 国标码 → 机内码的换算做过一题
- 大端/小端字节序写得出示例
- 三种溢出判断方法都会用
- 算术移位与逻辑移位的区别能举例
- 原码一位乘与 Booth 各手推过一题
- 原码除法(恢复余数/加减交替)思路能说清
- 浮点加减五步流程能默写,知道"对阶是小阶向大阶看齐"
- 海明码校验位数会算,会用校验和定位错位
- CRC 模 2 除法手算过一题
第 3 章
- CPU 四大功能与主要寄存器(PC/IR/MAR/MDR/AC/PSW)作用能默写
- 扩展操作码题做过两题,理解"操作码不能互为前缀"
- 八种寻址方式的有效地址会算(注意相对寻址用取指后的 PC)
- CISC 与 RISC 的对比表能默写
- MIPS32 的 R/I/J 型格式能画出
- 寄存器组、桶形移位器、ALU 的组成能说清
- 单总线数据通路能画出,
ADD指令的微操作序列与控制信号能逐拍写 - 硬布线与微程序控制器的组成、优缺点、适用场合能默写
- 微指令的三种编码方式会对比
- 会算控制存储器容量(指令数 × 微指令数 × 字长)
- 指令周期/机器周期/时钟周期的关系能画,四阶段能默写
- 单周期与多周期的 CPI、时钟周期取舍能解释,会算平均 CPI
- 五级流水线时空图会画,加速比/吞吐率/效率会算
- 三类冒险及解决办法能默写
- 超标量、超流水、VLIW、SIMD、多核的基本概念能区分
第 4 章
- 存储层次结构与局部性原理能画出/解释
- SRAM 与 DRAM 对比表能默写;三种刷新方式会说
- DRAM 集中刷新的死时间率会算
- ROM 家族与 Flash 的特点能区分
- 位扩展/字扩展/字位同时扩展的主存设计题做过一题
- Cache 三种映射方式、地址字段划分、比较器数量能对比
- Cache 地址划分题做过两题(直接映射与组相联各一)
- 平均访问时间与加速比会算
- 替换算法(FIFO/LRU/LFU)与写策略(写直达/写回)能对比
- 虚拟存储器与 Cache 的区别能说清
- 页式地址变换流程与 TLB 的作用能说清,页表大小会算
- 磁盘容量、存取时间、平均旋转等待时间会算
- RAID 0/1/5 的思想与冗余代价能对比
第 5、6 章
- 三总线(数据/地址/控制)的方向与作用能默写
- 总线带宽会算(含"每时钟传送几次"的坑)
- 三种集中式仲裁方式能对比
- 同步/异步定时、三种握手协议能对比
- 中断响应条件与处理流程能默写
- 中断屏蔽字表能推导
- DMA 与中断的区别表能默写;DMA 三种交换方式会说
- PIO/中断/DMA/IOP 的发展脉络能说清
- 键盘矩阵扫描与去抖能解释
- CRT 与 LCD 的区别、显存容量会算
- 激光/喷墨/点阵打印机原理能区分
附录 D 常用术语英中对照
| 缩写 | 英文 | 中文 |
|---|---|---|
| ALU | Arithmetic Logic Unit | 算术逻辑单元 |
| CPI | Cycles Per Instruction | 每条指令平均时钟周期数 |
| MIPS | Million Instructions Per Second | 每秒百万条指令 |
| PSW | Program Status Word | 程序状态字 |
| MAR / MDR | Memory Address / Data Register | 存储器地址 / 数据寄存器 |
| CISC / RISC | Complex / Reduced Instruction Set Computer | 复杂 / 精简指令集计算机 |
| EA | Effective Address | 有效地址 |
| TLB | Translation Lookaside Buffer | 快表 / 地址变换缓冲 |
| MMU | Memory Management Unit | 存储器管理部件 |
| SRAM / DRAM | Static / Dynamic Random Access Memory | 静态 / 动态随机存取存储器 |
| ROM | Read-Only Memory | 只读存储器 |
| RAID | Redundant Array of Independent Disks | 独立磁盘冗余阵列 |
| DMA | Direct Memory Access | 直接存储器存取 |
| IOP | Input/Output Processor | 输入输出处理机 |
| PIO | Programmed Input/Output | 程序控制输入输出 |
| CRC | Cyclic Redundancy Check | 循环冗余校验 |
| BCD | Binary-Coded Decimal | 二进制编码的十进制数 |
| ISA | Instruction Set Architecture | 指令集体系结构 |
| LSB / MSB | Least / Most Significant Bit | 最低 / 最高有效位 |
| BTB | Branch Target Buffer | 分支目标缓冲(分支预测) |
全文完。复习顺序建议:第 2、3、4 章(分值最高,以计算与设计为主)→ 第 1 章(概念 + 小计算)→ 第 5 章(总线带宽、中断与 DMA)→ 第 6 章(记忆为主)。考前最后一晚只看附录 B、C 与各章"典型题"。